パッケージの概要
rpart (Recursive Partitioning And Regression Trees)は、再帰的分割(データをグループに分けることを繰り返して木構造を作る手法)によって回帰木・分類木を構築するためのパッケージです。また、rpart.plot パッケージを用いることで、決定木をより見やすい形で可視化することができます。
使用例:Bostonデータ
MASSパッケージに含まれるBostonデータを用いて、住宅価格の中央値を推定する回帰木の構築を試してみます。
データの確認
Bostonデータを読み込みます。12列目(black)は使用しないこととします。
library(MASS)
df <- Boston[, -12]
str(df)
'data.frame':   506 obs. of  13 variables:
 $ crim   : num  0.00632 0.02731 0.02729 0.03237 0.06905 ...
 $ zn     : num  18 0 0 0 0 0 12.5 12.5 12.5 12.5 ...
 $ indus  : num  2.31 7.07 7.07 2.18 2.18 2.18 7.87 7.87 7.87 7.87 ...
 $ chas   : int  0 0 0 0 0 0 0 0 0 0 ...
 $ nox    : num  0.538 0.469 0.469 0.458 0.458 0.458 0.524 0.524 0.524 0.524 ...
 $ rm     : num  6.58 6.42 7.18 7 7.15 ...
 $ age    : num  65.2 78.9 61.1 45.8 54.2 58.7 66.6 96.1 100 85.9 ...
 $ dis    : num  4.09 4.97 4.97 6.06 6.06 ...
 $ rad    : int  1 2 2 3 3 3 5 5 5 5 ...
 $ tax    : num  296 242 242 222 222 222 311 311 311 311 ...
 $ ptratio: num  15.3 17.8 17.8 18.7 18.7 18.7 15.2 15.2 15.2 15.2 ...
 $ lstat  : num  4.98 9.14 4.03 2.94 5.33 ...
 $ medv   : num  24 21.6 34.7 33.4 36.2 28.7 22.9 27.1 16.5 18.9 ...
各変数の意味は以下の通りです。
| crim |
町別の「犯罪率」 |
| zn |
25,000平方フィートを超える区画に分類される住宅地の割合 |
| indus |
町別の「非小売業の割合」 |
| chas |
チャールズ川のダミー変数(区画が川に接している場合は1、そうでない場合は0) |
| nox |
「NOx濃度(0.1ppm単位)」=一酸化窒素濃度 |
| rm |
1戸当たりの「平均部屋数」 |
| age |
1940年より前に建てられた持ち家の割合 |
| dis |
5つあるボストン雇用センターまでの加重距離 |
| rad |
「主要高速道路へのアクセス性」の指数 |
| tax |
10,000ドル当たりの「固定資産税率」 |
| ptratio |
町別の「生徒と先生の比率」 |
| lstat |
「低所得者人口の割合」 |
| medv |
「住宅価格」(1000ドル単位)の中央値(目的変数) |
数値変数について、medvとの散布図を確認します。
library(ggplot2)
library(dplyr)
Attaching package: 'dplyr'
The following object is masked from 'package:MASS':

    select
The following objects are masked from 'package:stats':

    filter, lag
The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
# データ読み込み
data("Boston")
df <- Boston

# 目的変数と説明変数(数値)
target <- "medv"
num_vars <- c("crim", "zn", "indus", "nox", "rm", "age", "dis", "tax", "ptratio", "lstat")

# long形式に変換
df_long_num <- df %>%
  select(all_of(c(target, num_vars))) %>%
  pivot_longer(cols = all_of(num_vars),
               names_to = "variable", values_to = "value")

# 散布図
ggplot(df_long_num, aes(x = value, y = .data[[target]])) +
  geom_point(alpha = 0.6) +
  facet_wrap(~variable, scales = "free_x") +
  theme_minimal()
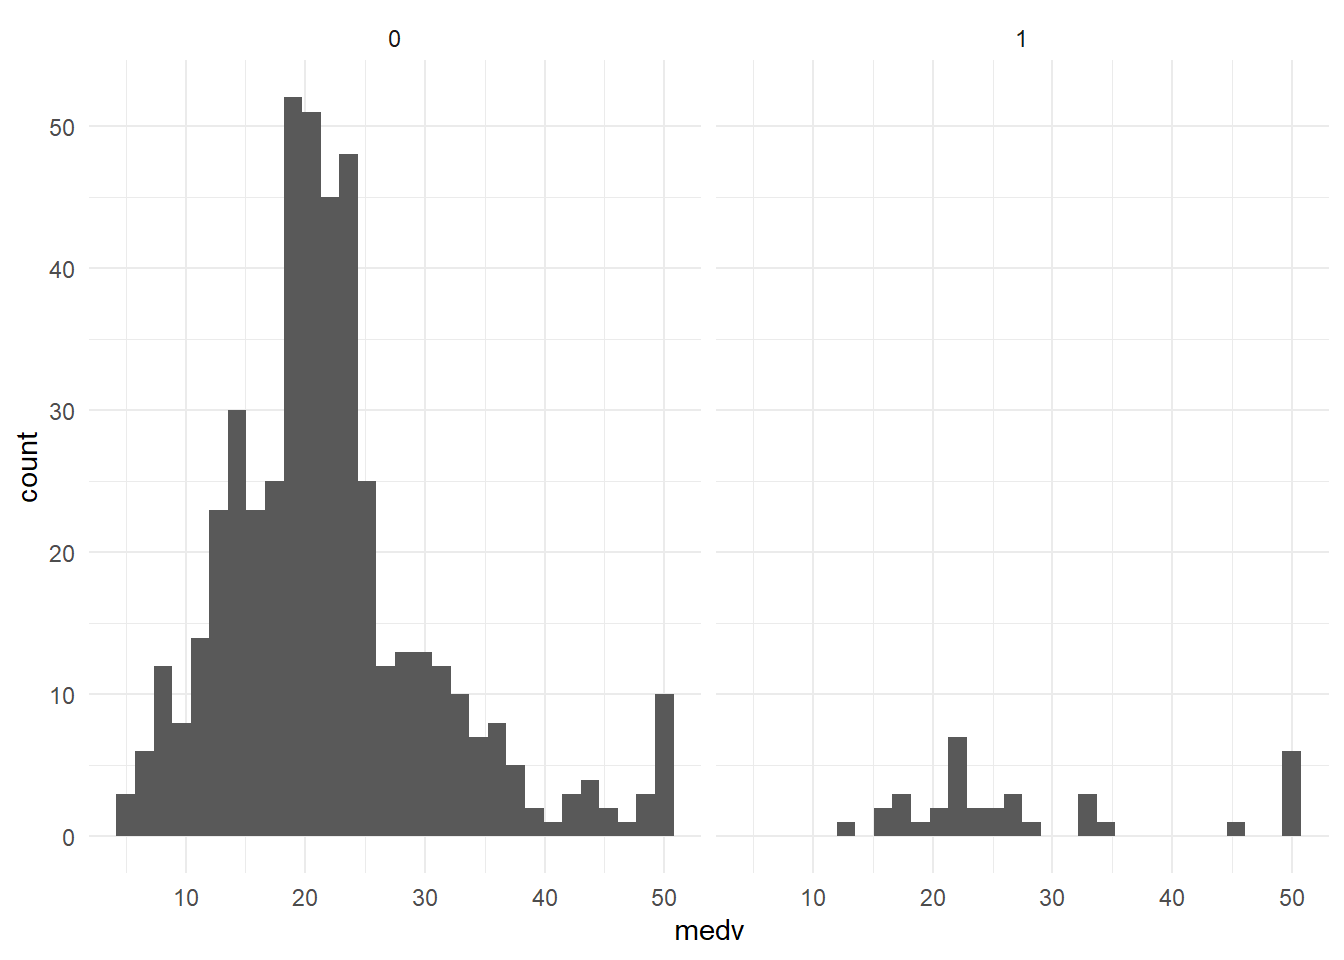
カテゴリ変数について、medvのヒストグラムを確認します。以下は、変数chas(チャールズ川に接しているかどうか)についてのヒストグラムです。
# chas
ggplot(df, aes(x = medv)) +
  geom_histogram(bins = 30) +
  facet_wrap(~chas) +
  theme_minimal()
以下は、変数rad(「主要高速道路へのアクセス性」の指数)についてのヒストグラムです。
# rad
ggplot(df, aes(x = medv)) +
  geom_histogram(bins = 30) +
  facet_wrap(~rad) +
  theme_minimal()
モデル構築1(全体データ)
まずは全てのデータを使って分類木モデルを構築してみます。
library(rpart)
library(rpart.plot)
# シードを設定
set.seed(123)
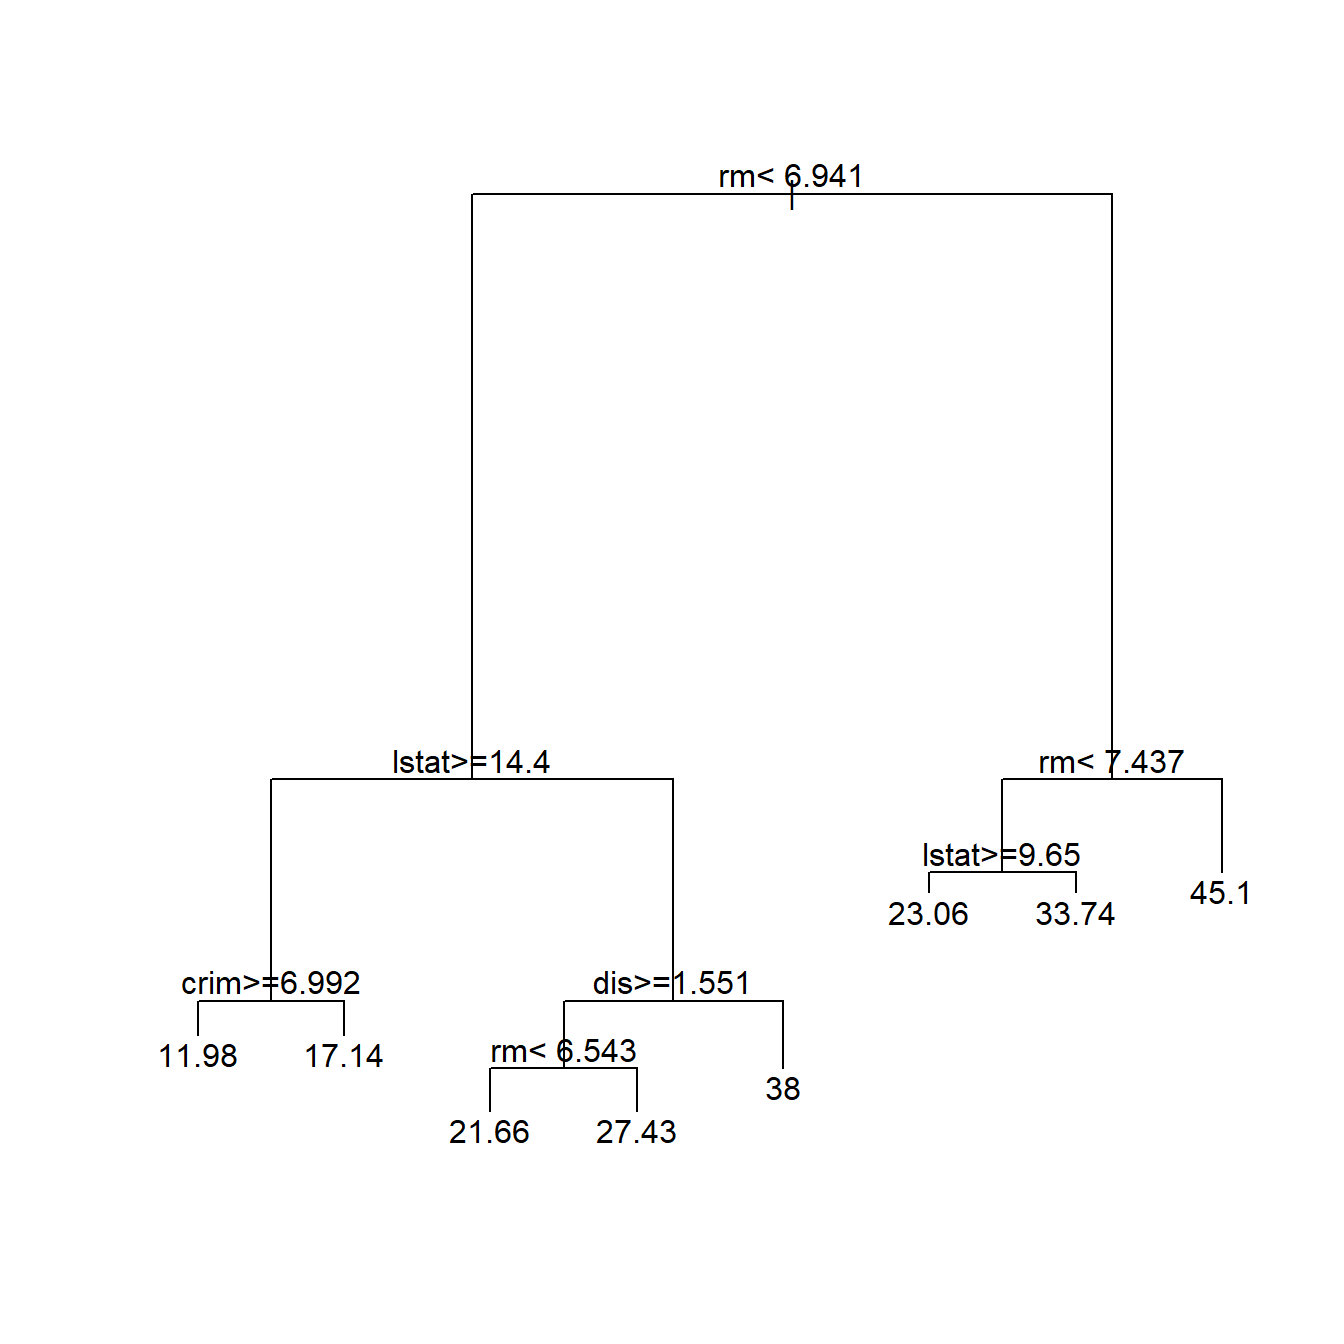
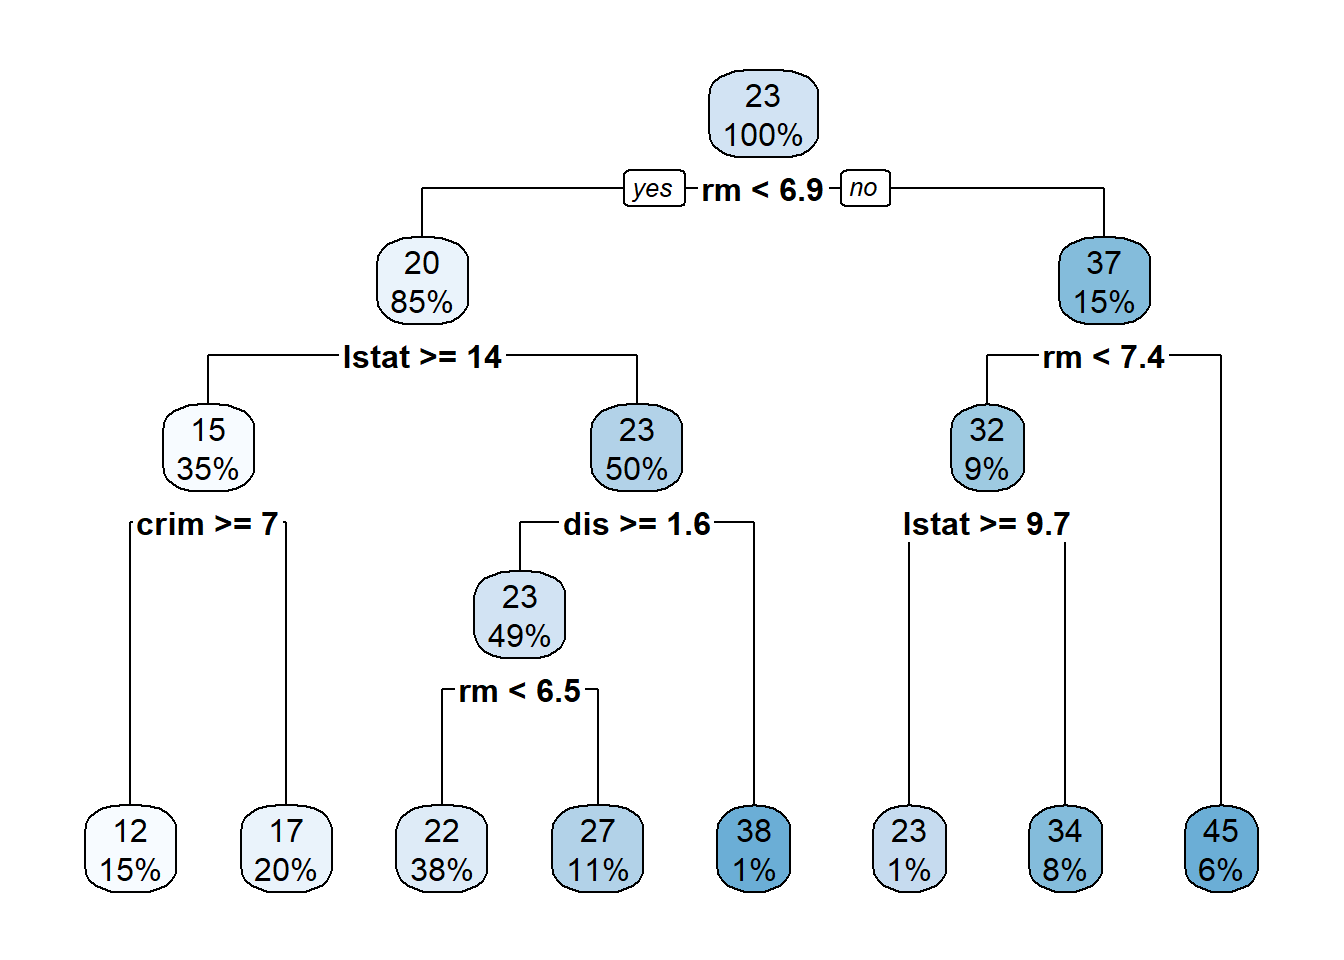
(model <- rpart(medv ~ ., data = df))
n= 506

node), split, n, deviance, yval
      * denotes terminal node

 1) root 506 42716.3000 22.53281
   2) rm< 6.941 430 17317.3200 19.93372
     4) lstat>=14.4 175  3373.2510 14.95600
       8) crim>=6.99237 74  1085.9050 11.97838 *
       9) crim< 6.99237 101  1150.5370 17.13762 *
     5) lstat< 14.4 255  6632.2170 23.34980
      10) dis>=1.5511 248  3658.3930 22.93629
        20) rm< 6.543 193  1589.8140 21.65648 *
        21) rm>=6.543 55   643.1691 27.42727 *
      11) dis< 1.5511 7  1429.0200 38.00000 *
   3) rm>=6.941 76  6059.4190 37.23816
     6) rm< 7.437 46  1899.6120 32.11304
      12) lstat>=9.65 7   432.9971 23.05714 *
      13) lstat< 9.65 39   789.5123 33.73846 *
     7) rm>=7.437 30  1098.8500 45.09667 *
モデルの可視化
モデルを可視化します。plotで木の構造(分岐)を表示し、textで各ノードの分岐の基準や分類ラベルを表示します。
rpart.plotを用いると、分類木をより分かりやすく表示させることができます。
モデル構築2(訓練データとテストデータに分割)
Bostonデータをモデル生成のための訓練データと、モデル評価のためのテストデータに分割します。データ割合は訓練データを7割、テストデータを3割とします。確認のため、データサイズを出力します。
# シードを設定
set.seed(123)

# データの分割
sample_indices <- sample(1:nrow(df), 0.7 * nrow(df))
df.train <- df[sample_indices, ]
df.test <- df[-sample_indices, ]

# データサイズの確認
c(nrow(df), nrow(df.train), nrow(df.test))
モデル生成
訓練データを用いて分類木モデルを生成します。
# シードを設定
set.seed(123)
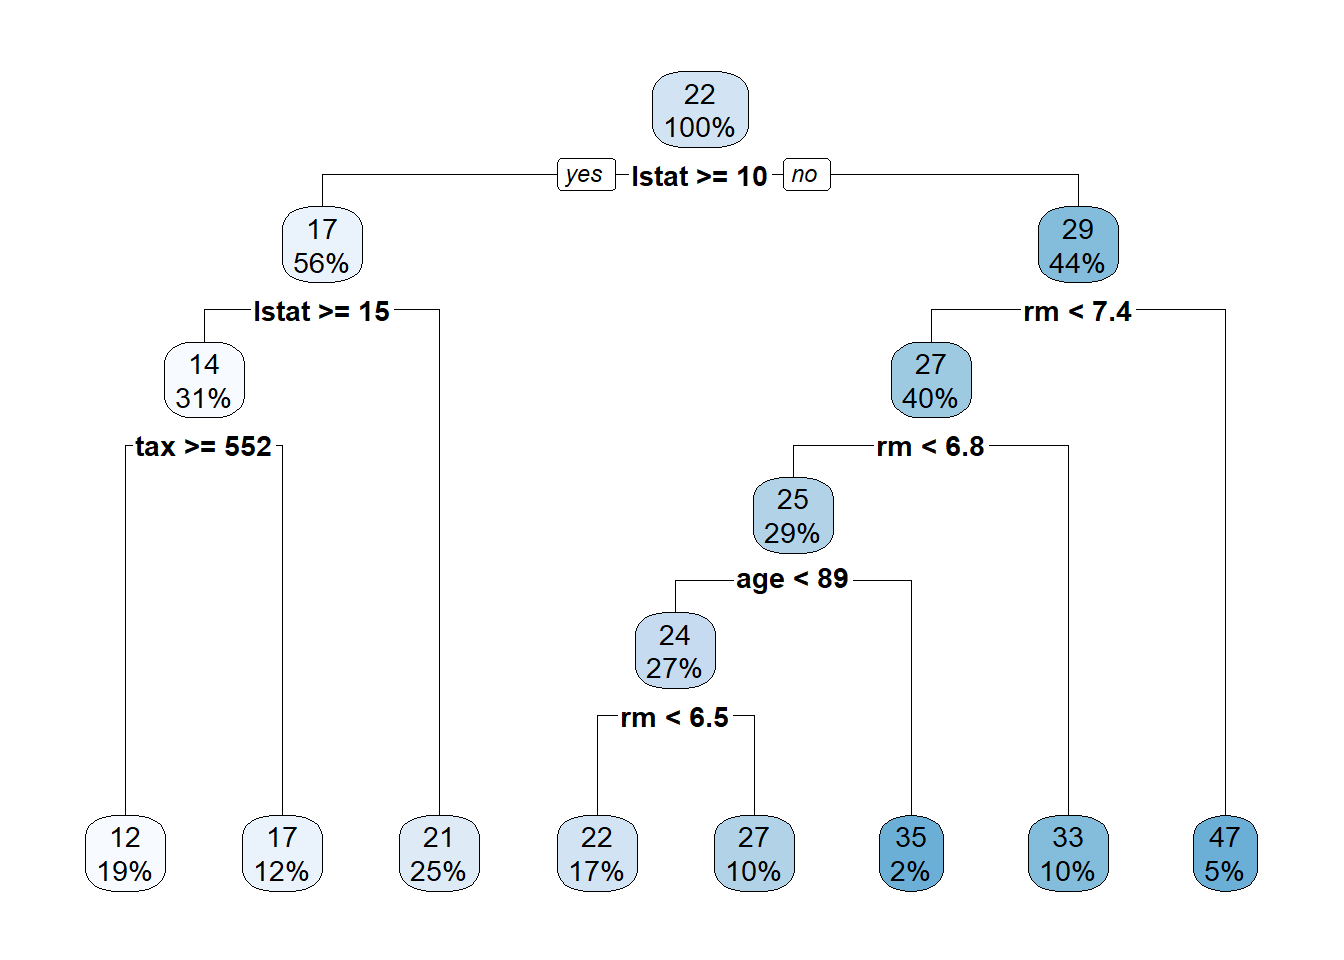
model2 <- rpart(medv ~ ., data = df.train)
rpart.plotでモデルを可視化します。
モデル評価
テストデータを使ってモデル評価を行います。まずはテストデータを元に生成したモデルを用いて予測結果を算出します。
res_act <- df.test$medv
res_pred <- predict(model2, df.test, type = "vector")
モデル性能の評価のために、二乗平均平方根誤差(RMSE: Root Mean Squared Error)と決定係数(R²: Coefficient of Determination)を算出します。
Attaching package: 'MLmetrics'
The following object is masked from 'package:base':

    Recall
sprintf("RMSE : %.3f", RMSE(res_act, res_pred))
sprintf("決定係数 : %.3f", R2_Score(res_act, res_pred))
ハイパーパラメーターのチューニング
rpartの主なハイパーパラメーターは以下の通りです。
- 木の複雑度に関するパラメータ(cp)
- ノード分割の最小サンプル数(minsplit)
- 木の最大の深さ(maxdepth)
これらのハイパーパラメータの最適な設定を探す作業がハイパーパラメーターのチューニングとなります。
各ハイパーパラメータは相互に影響を及ぼすため、ハイパーパラメータのチューニングは個別のパラメータごとに行うのではなく、対象のパラメータを同時に行う必要があります。ここではcpとminsplitのグリッドサーチにより、最適なパラメータを探す作業を行います。
data.frameの出力整形用の関数を定義します。
library(knitr)
library(kableExtra)
Attaching package: 'kableExtra'
The following object is masked from 'package:dplyr':

    group_rows
show_df <- function(df, cap=""){
  if(is_html_output()){
    kable(df, format = "html", caption = cap) %>%
      kable_styling(bootstrap_options = "striped", full_width = FALSE, position = "left")
  }else{
    kable(df, format = "pipe", caption = cap)
  }
}
チューニング候補値です。expand.gridを作って全ての組み合わせを列挙します。
param_grid <- expand.grid(
  cp = c(0.01, 0.03, 0.05),
  minsplit = c(10, 20, 30, 40, 50)
)
各パラメータでモデル精度を検証してゆきます。
#結果保存用
results <- data.frame(
  cp = numeric(),
  minsplit = integer(),
  RMSE = numeric(),
  R2_Score = numeric()
)

set.seed(123)
for (i in 1:nrow(param_grid)) {
  params <- param_grid[i, ]

  model3 <- rpart(
    medv ~ .,
    data = df.train,
    control = rpart.control(cp = params$cp, minsplit = params$minsplit),
  )

  res_pred <- predict(model3, df.test, type = "vector")

  results <- rbind(results, data.frame(
    cp = params$cp,
    minsplit = params$minsplit,
    RMSE = round(RMSE(res_act, res_pred), 3),
    R2_Score = round(R2_Score(res_act, res_pred), 3)
  ))
}

show_df(results)
| 0.01 |
10 |
4.617 |
0.771 |
| 0.03 |
10 |
4.852 |
0.734 |
| 0.05 |
10 |
4.852 |
0.734 |
| 0.01 |
20 |
4.873 |
0.737 |
| 0.03 |
20 |
4.934 |
0.724 |
| 0.05 |
20 |
5.202 |
0.691 |
| 0.01 |
30 |
5.134 |
0.713 |
| 0.03 |
30 |
5.202 |
0.691 |
| 0.05 |
30 |
5.202 |
0.691 |
| 0.01 |
40 |
4.961 |
0.726 |
| 0.03 |
40 |
5.202 |
0.691 |
| 0.05 |
40 |
5.202 |
0.691 |
| 0.01 |
50 |
5.147 |
0.709 |
| 0.03 |
50 |
5.202 |
0.691 |
| 0.05 |
50 |
5.202 |
0.691 |
RMSEが小さく決定係数が大きな組み合わせであるcp = 0.01、minsplit = 10の設定が良さそうであることが分かりました。より汎化性能を高めるためには、クロスバリデーションを行う必要があります。
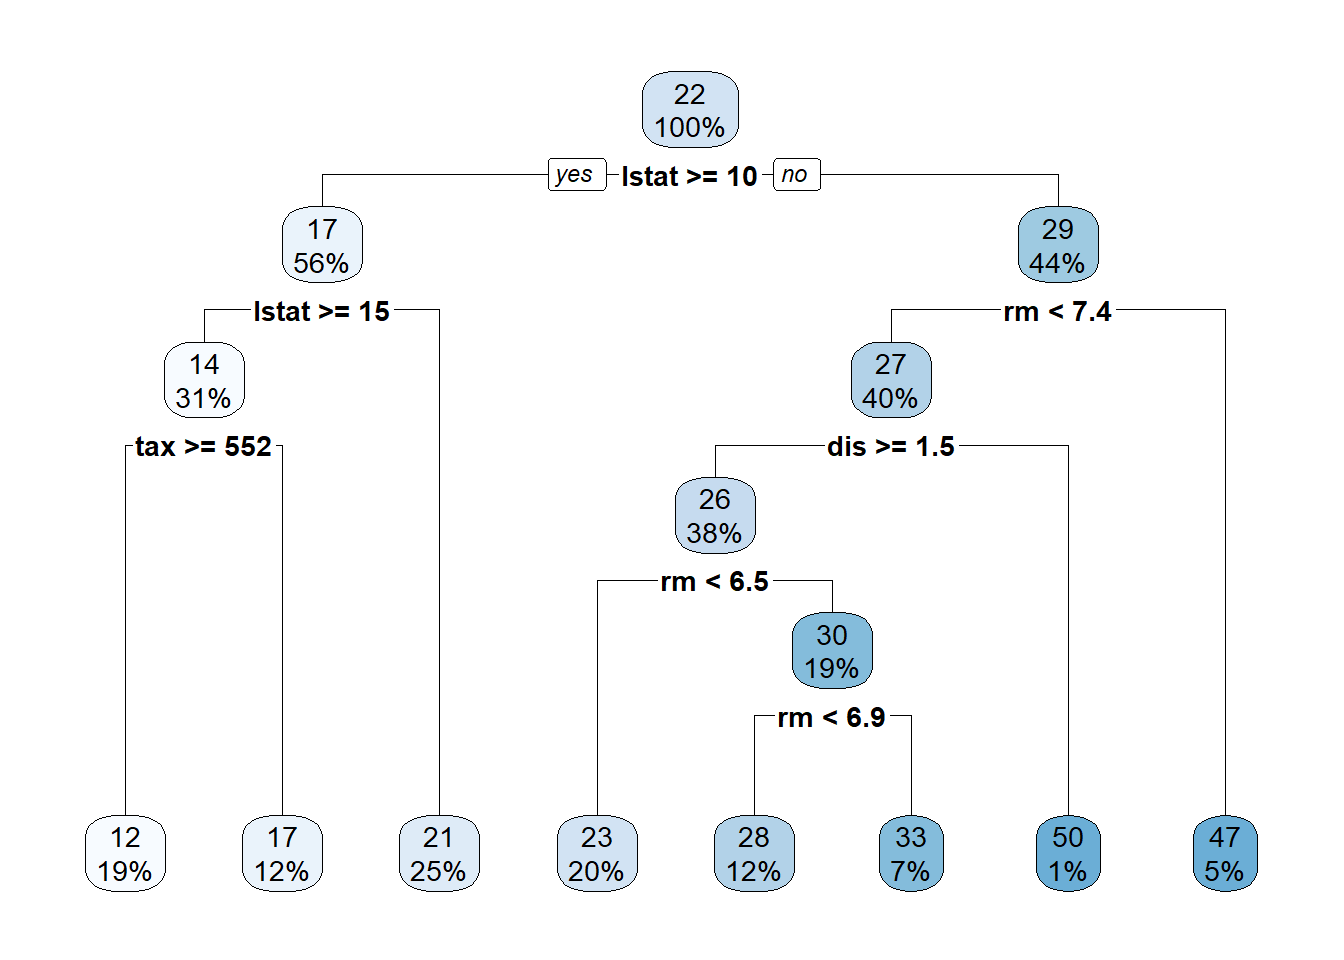
このモデルの分類木を可視化してみましょう。木の形も少し変わっています。
# シードを設定
set.seed(123)

model4 <- rpart(
  medv ~ .,
  data = df.train,
  control = rpart.control(cp = 0.01, minsplit = 10)
)

rpart.plot(model4)