パッケージの概要
GGallyは、Rの可視化パッケージggplot2を拡張するパッケージです。ggpairs関数やggduo関数で変数同士の箱ひげ図や散布図などを一度に確認したり、ggcorr関数で変数間の相関を確認できます。
library (ggplot2)library (GGally)library (insuranceData)library (tibble)library (tidyr)library (knitr)library (dplyr) # stats,baseの関数がマスクされる
Attaching package: 'dplyr'
The following objects are masked from 'package:stats':

    filter, lag
The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
ggpairs関数を利用した可視化
insuranceDataパッケージのAutoBiを題材に、ggpairs関数の利用方法を確認します。
AutoBiデータの各変数説明
CASENUM
請求案件を識別するケース番号
ATTORNEY
弁護士利用の有無(1=あり, 2=なし)
CLMSEX
請求者の性別(1=男性, 2=女性)
MARITAL
婚姻状況(1=既婚, 2=独身, 3=配偶者と死別, 4=離婚・別居)
CLMINSUR
保険加入状況(1=加入, 2=未加入)
SEATBELT
シートベルト着用状況(1=着用, 2=未着用)
CLMAGE
請求者の年齢
LOSS
損失額(千ドル単位)
data (AutoBi)<- as_tibble (AutoBi)
# A tibble: 1,340 × 8
   CASENUM ATTORNEY CLMSEX MARITAL CLMINSUR SEATBELT CLMAGE   LOSS
     <int>    <int>  <int>   <int>    <int>    <int>  <int>  <dbl>
 1       5        1      1      NA        2        1     50 34.9
 2      13        2      2       2        1        1     28 10.9
 3      66        2      1       2        2        1      5  0.33
 4      71        1      1       1        2        2     32 11.0
 5      96        2      1       4        2        1     30  0.138
 6      97        1      2       1        2        1     35  0.309
 7     120        1      1       2        2        1     19  3.54
 8     136        1      2       2        2        1     34  4.88
 9     152        2      2       2        2        1     61  0.874
10     155        2      1       2        2        1     NA  1.35
# ℹ 1,330 more rows
    CASENUM         ATTORNEY         CLMSEX         MARITAL
 Min.   :    5   Min.   :1.000   Min.   :1.000   Min.   :1.000
 1st Qu.: 8579   1st Qu.:1.000   1st Qu.:1.000   1st Qu.:1.000
 Median :17453   Median :1.000   Median :2.000   Median :2.000
 Mean   :17213   Mean   :1.489   Mean   :1.559   Mean   :1.593
 3rd Qu.:25703   3rd Qu.:2.000   3rd Qu.:2.000   3rd Qu.:2.000
 Max.   :34253   Max.   :2.000   Max.   :2.000   Max.   :4.000
                                 NA's   :12      NA's   :16
    CLMINSUR        SEATBELT         CLMAGE           LOSS
 Min.   :1.000   Min.   :1.000   Min.   : 0.00   Min.   :   0.005
 1st Qu.:2.000   1st Qu.:1.000   1st Qu.:19.00   1st Qu.:   0.640
 Median :2.000   Median :1.000   Median :31.00   Median :   2.331
 Mean   :1.908   Mean   :1.017   Mean   :32.53   Mean   :   5.953
 3rd Qu.:2.000   3rd Qu.:1.000   3rd Qu.:43.00   3rd Qu.:   3.995
 Max.   :2.000   Max.   :2.000   Max.   :95.00   Max.   :1067.697
 NA's   :41      NA's   :48      NA's   :189
デフォルト設定で実行
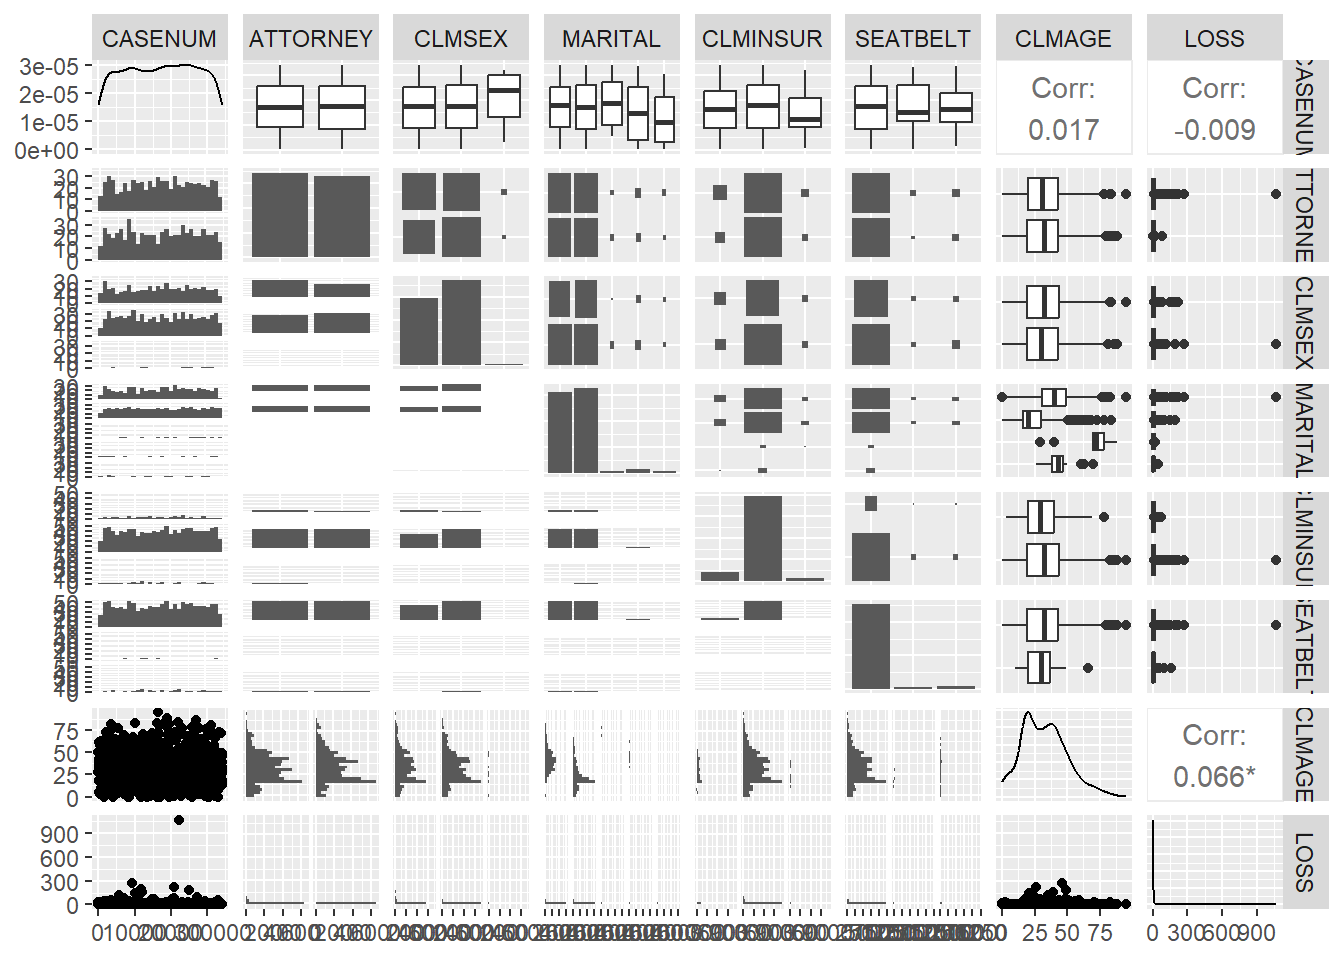
ATTORNEYなどをカテゴリ変数に変更したうえで、何も引数を指定せずにggpairs関数を実行(ワーニングなどは非表示にしています。)します。 結果は出力できますが、ggpairs関数では全ての変数同士の組み合わせで結果を表示することから、数が多くなりすぎてしまい、目盛りなども読み取ることができません。
# カテゴリ変数をfactorに変換 <- df %>% mutate (ATTORNEY = factor (ATTORNEY, labels = c ("Yes" , "No" )),CLMSEX = factor (CLMSEX, labels = c ("Male" , "Female" )),MARITAL = factor (MARITAL,labels = c ("Married" , "Single" , "Widowed" , "Divorced" )),CLMINSUR = factor (CLMINSUR,labels = c ("Yes" , "No" )),SEATBELT = factor (SEATBELT,labels = c ("Yes" , "No" ))ggpairs (df)
変数を絞って実行
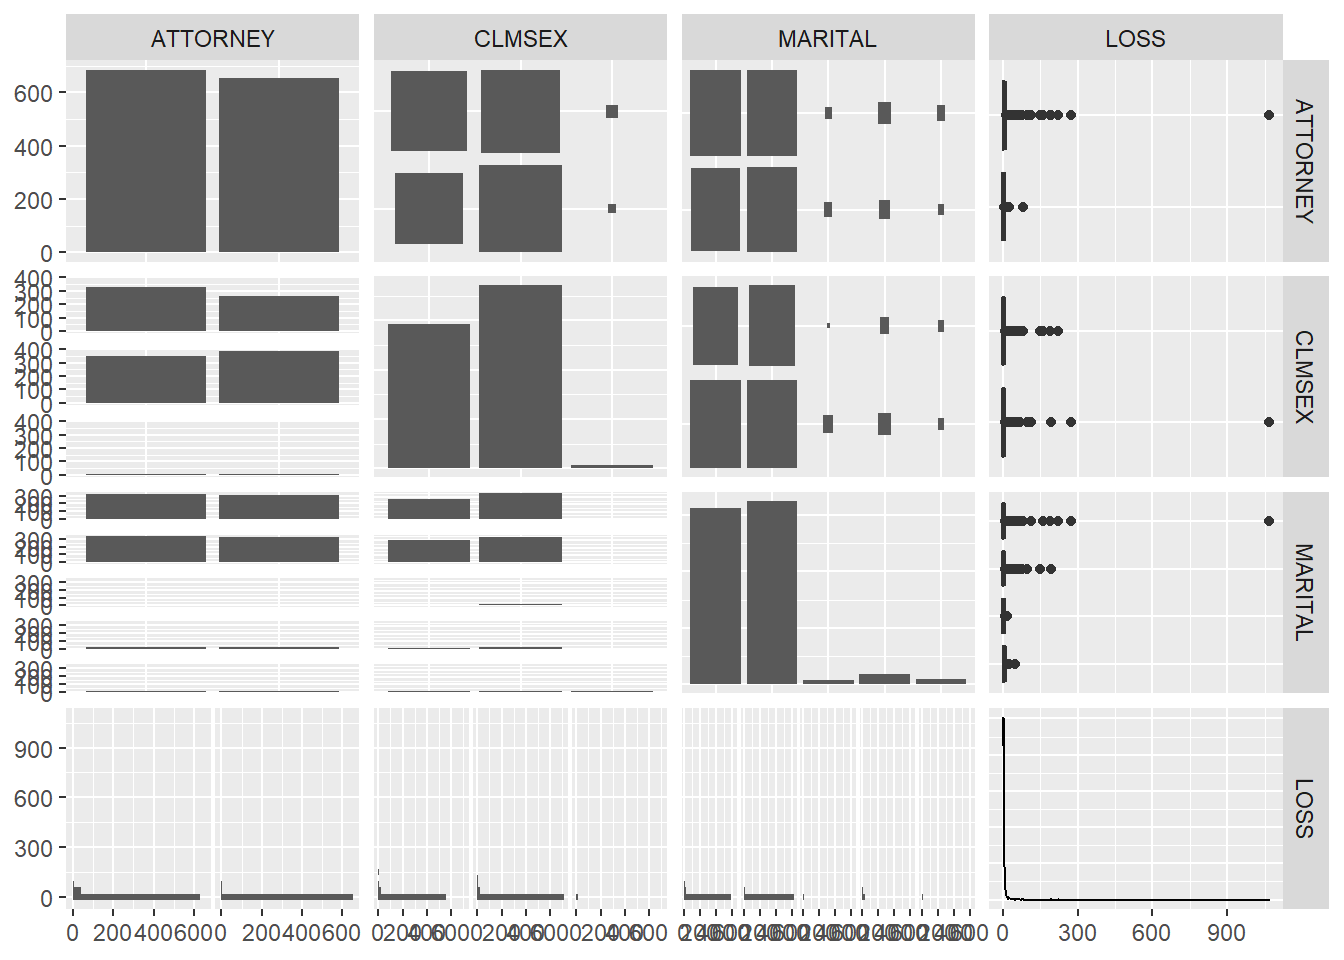
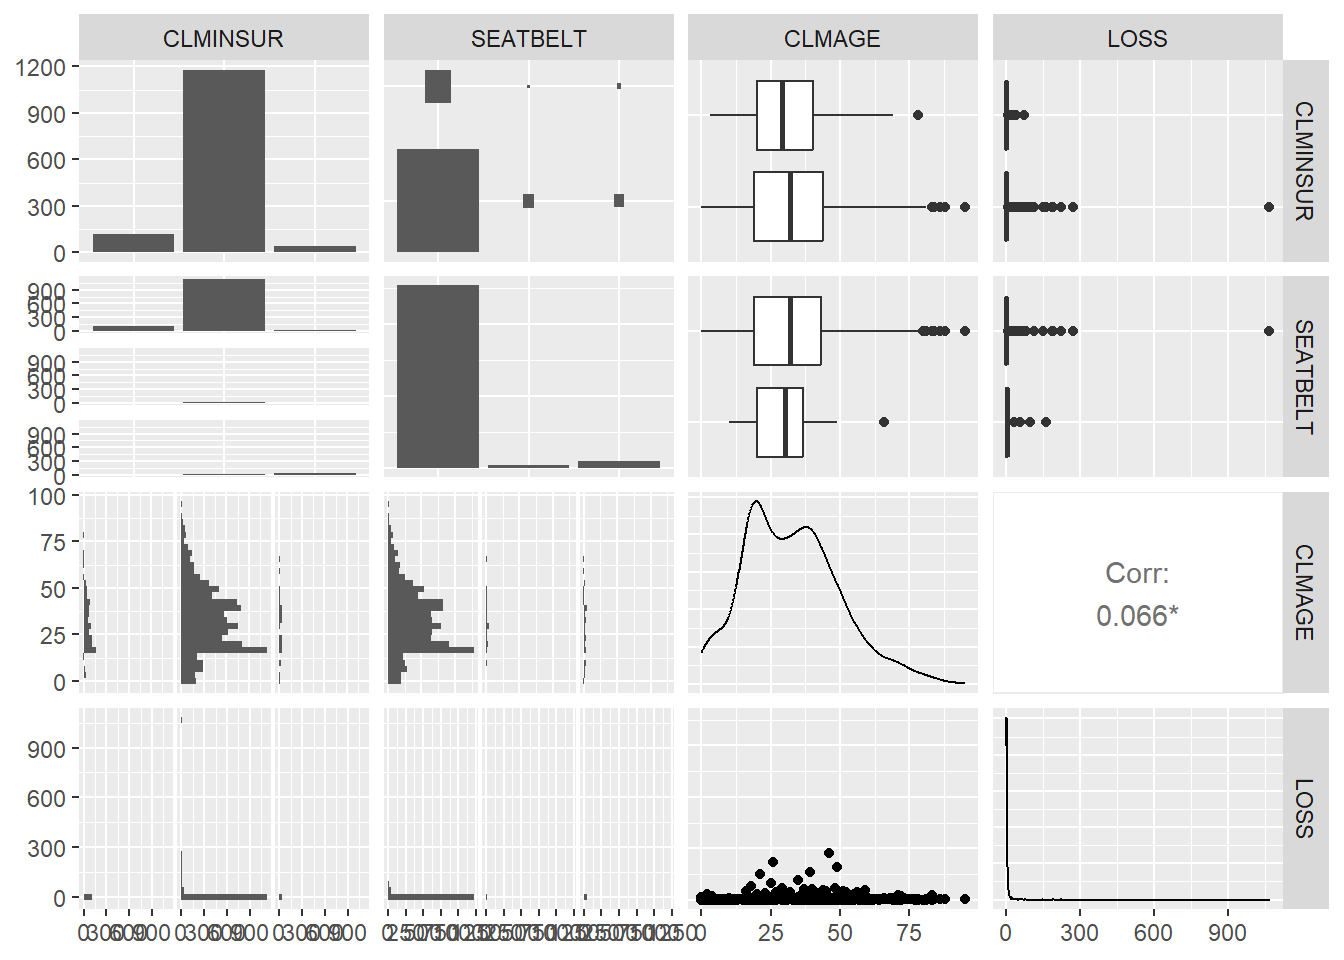
表示される数を減らすため、変数を2つのグループに分けます。ただし、CASENUMはデータ番号となり、特に意味はないため除外します。また、LOSSは重要な項目であるため、どちらの変数グループにも含めます。
ggpairs (df[, c ("ATTORNEY" , "CLMSEX" , "MARITAL" ,"LOSS" )])ggpairs (df[, c ("CLMINSUR" , "SEATBELT" , "CLMAGE" , "LOSS" )])
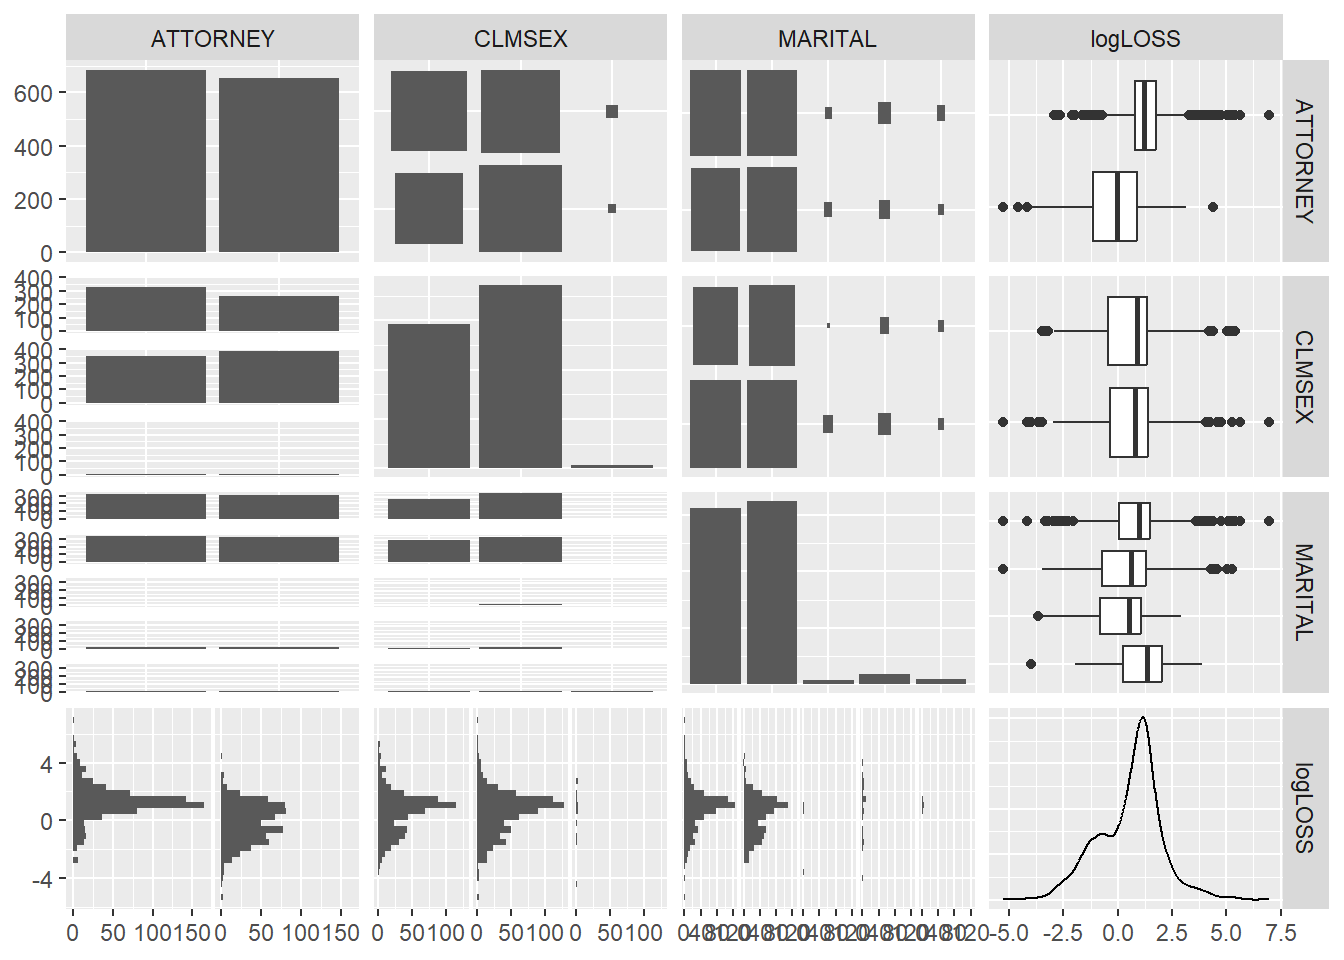
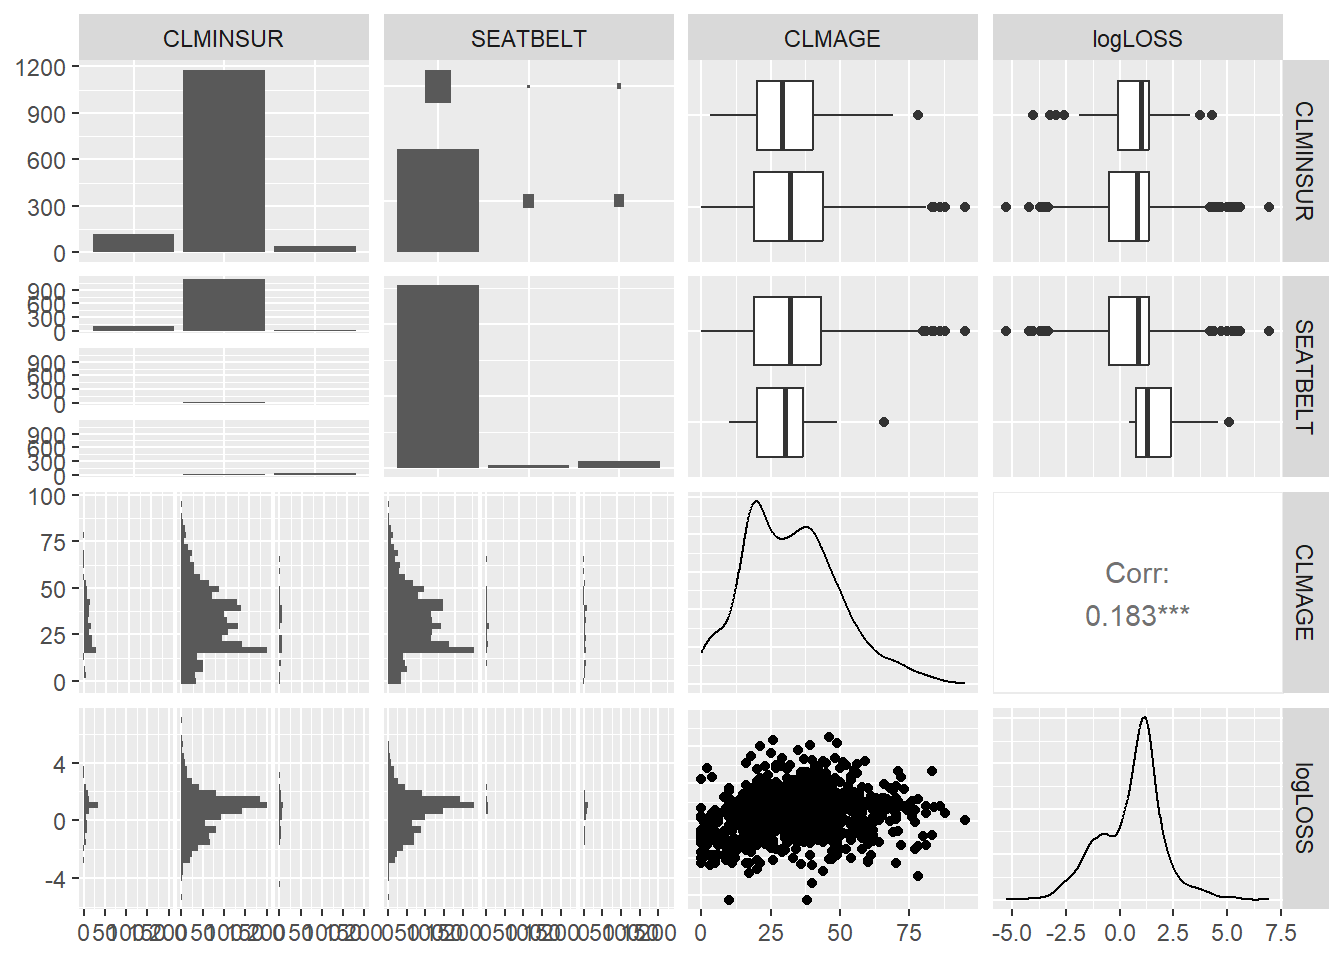
表示される数が少なく、前よりも見やすくなりました。ただ、LOSSは一部の数字だけが極端に大きく、傾向を把握しにくくなっているため、対数変換を行います。
$ logLOSS <- log (df$ LOSS)ggpairs (df[, c ("ATTORNEY" , "CLMSEX" , "MARITAL" ,"logLOSS" )])ggpairs (df[, c ("CLMINSUR" , "SEATBELT" , "CLMAGE" , "logLOSS" )])
LOSSの傾向が確認しやすくなりました。
表示する情報の指定
ggpairsの出力結果は、変数の組み合わせなどに応じて選択されますが、自分で指定することもできます。 指定する際は「情報が表示される領域」と「変数の種類(カテゴリ変数、数値変数など)の組み合わせ」ごとに指定します。「情報が表示される領域」は、対角線の部分(左上から右下まで)と、対角線の上側の部分、下側の部分の3つに区分でき、各区分ごとに出力する内容を指定できます。
  出力位置 指定方法
1   対角線     diag
2   上半分    upper
3   下半分    lower
        組み合わせの種類   指定方法
1           数値変数同士 continuous
2 カテゴリ変数と数値変数      combo
3       カテゴリ変数同士   discrete
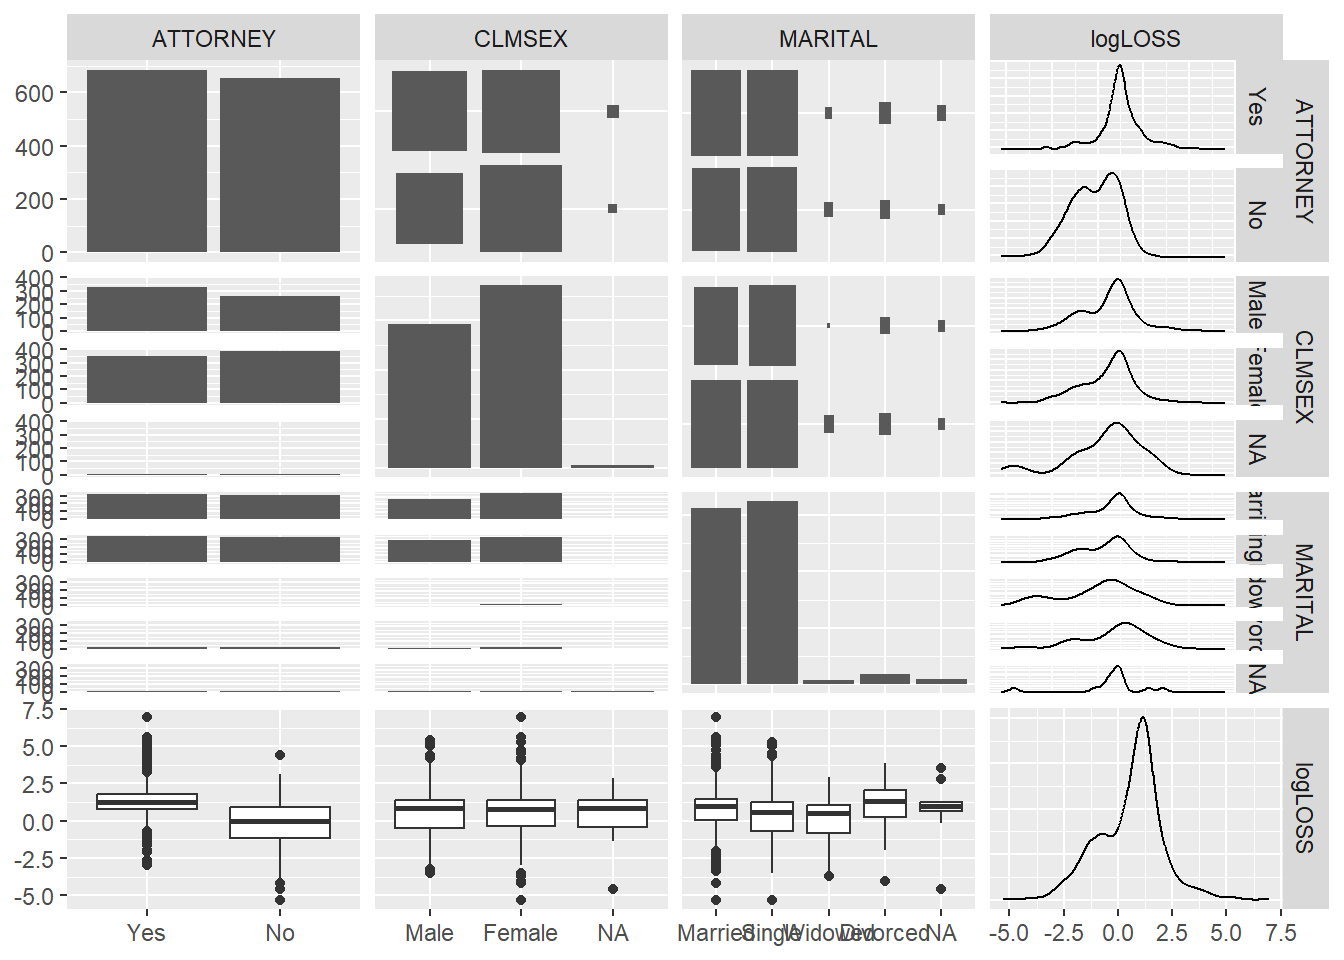
各区分ごとに表示する情報を指定します。どのような情報を指定しているかは、コメントに記載しています。 また、見栄えも順次調整していきます。
ggpairs (c ("ATTORNEY" , "CLMSEX" , "MARITAL" , "logLOSS" )],upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ
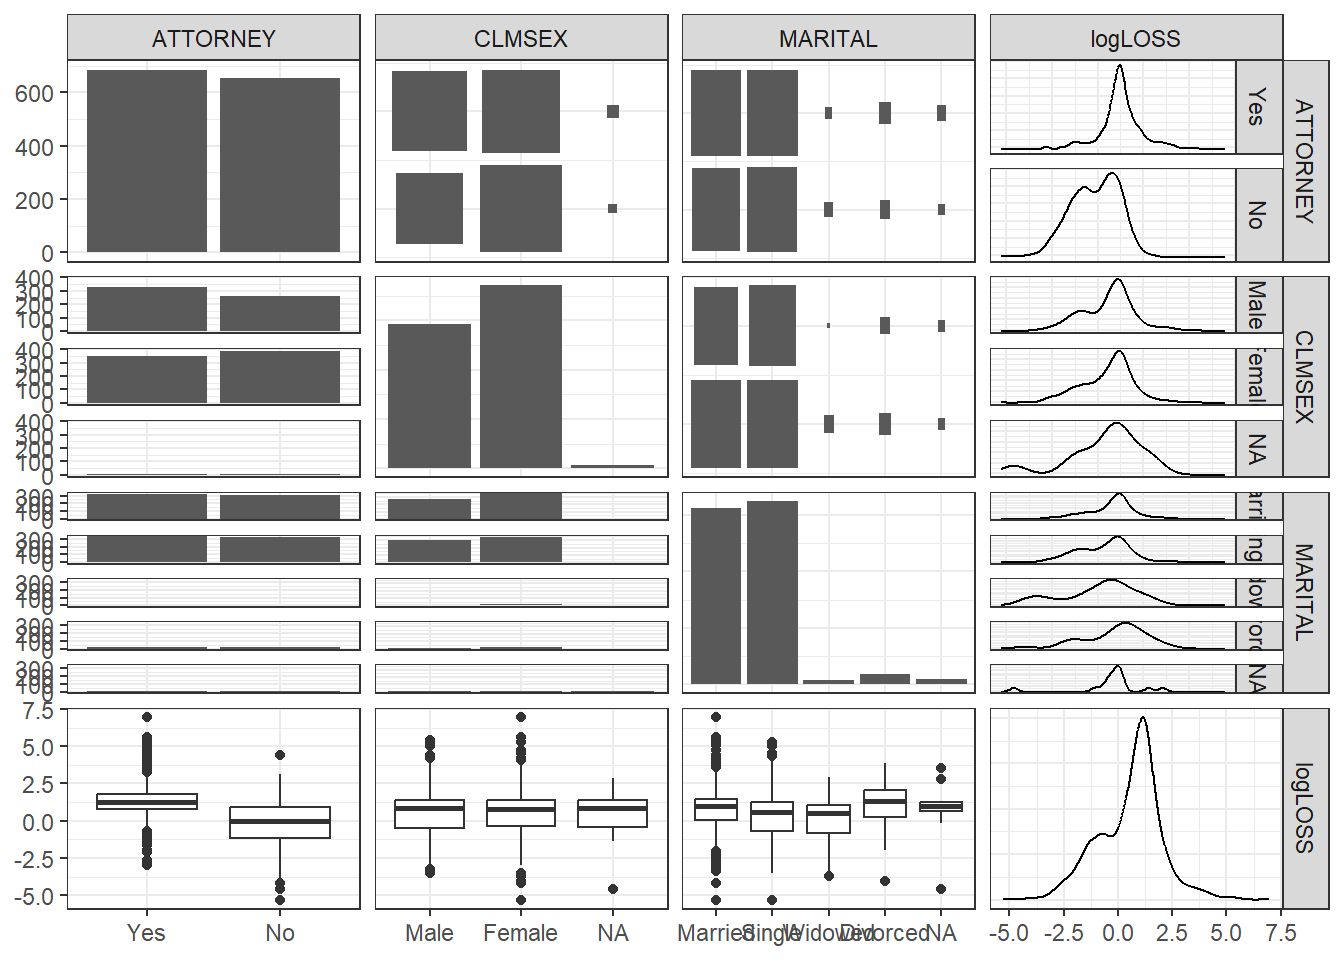
背景をホワイトベースに変更
ggpairs (c ("ATTORNEY" , "CLMSEX" , "MARITAL" , "logLOSS" )],upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ + theme_bw () # 背景を白に
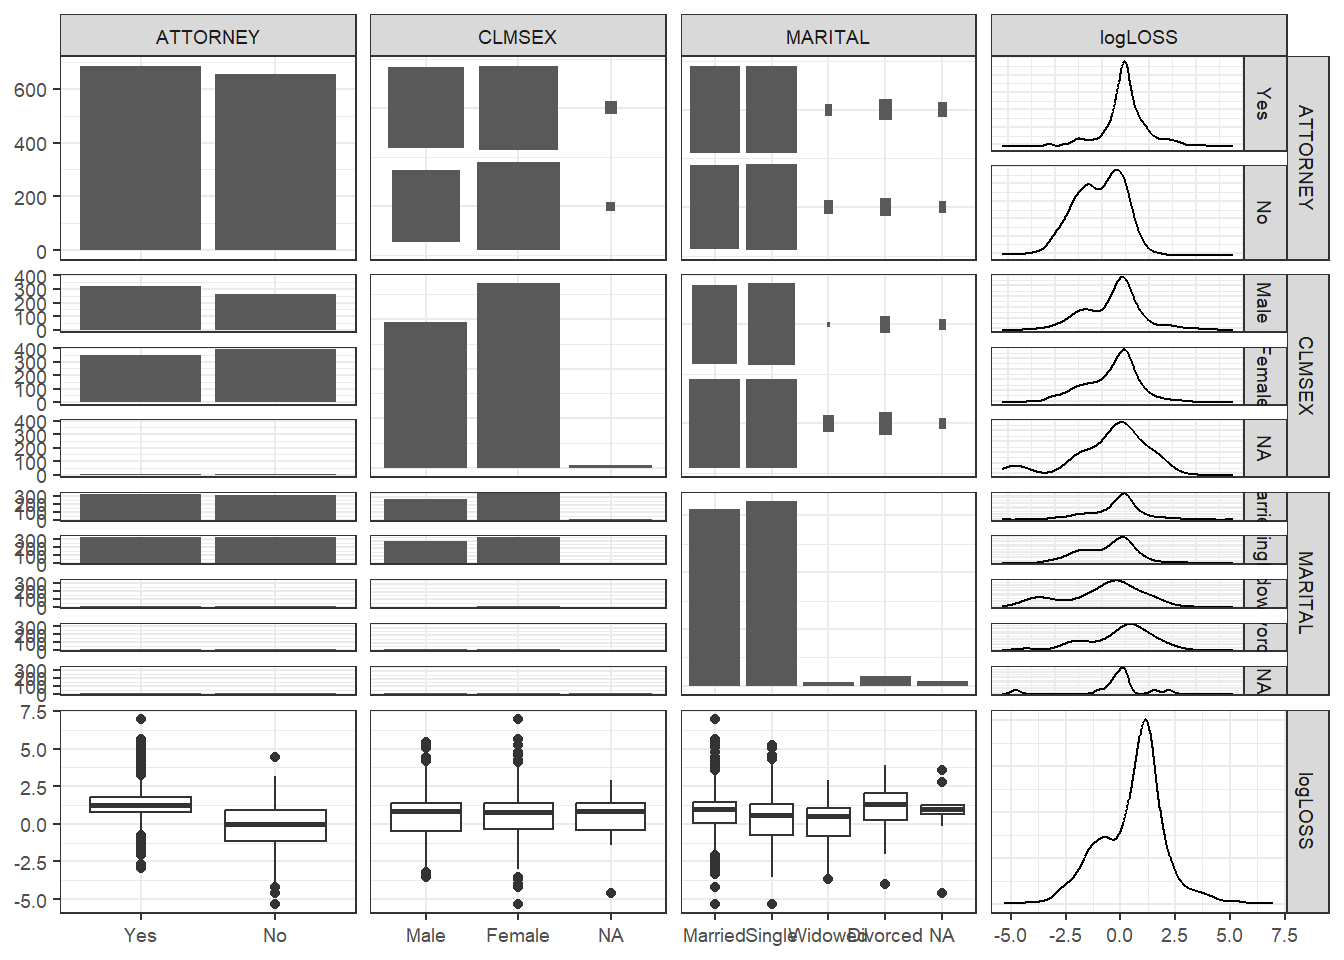
ggpairs (c ("ATTORNEY" , "CLMSEX" , "MARITAL" , "logLOSS" )],upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ + theme_bw () + # 背景を白に theme (axis.text = element_text (size = 7 ), # 軸メモリのサイズ指定 strip.text = element_text (size = 7 ), # パネルタイトルのサイズ指定
X軸のメモリを微調整
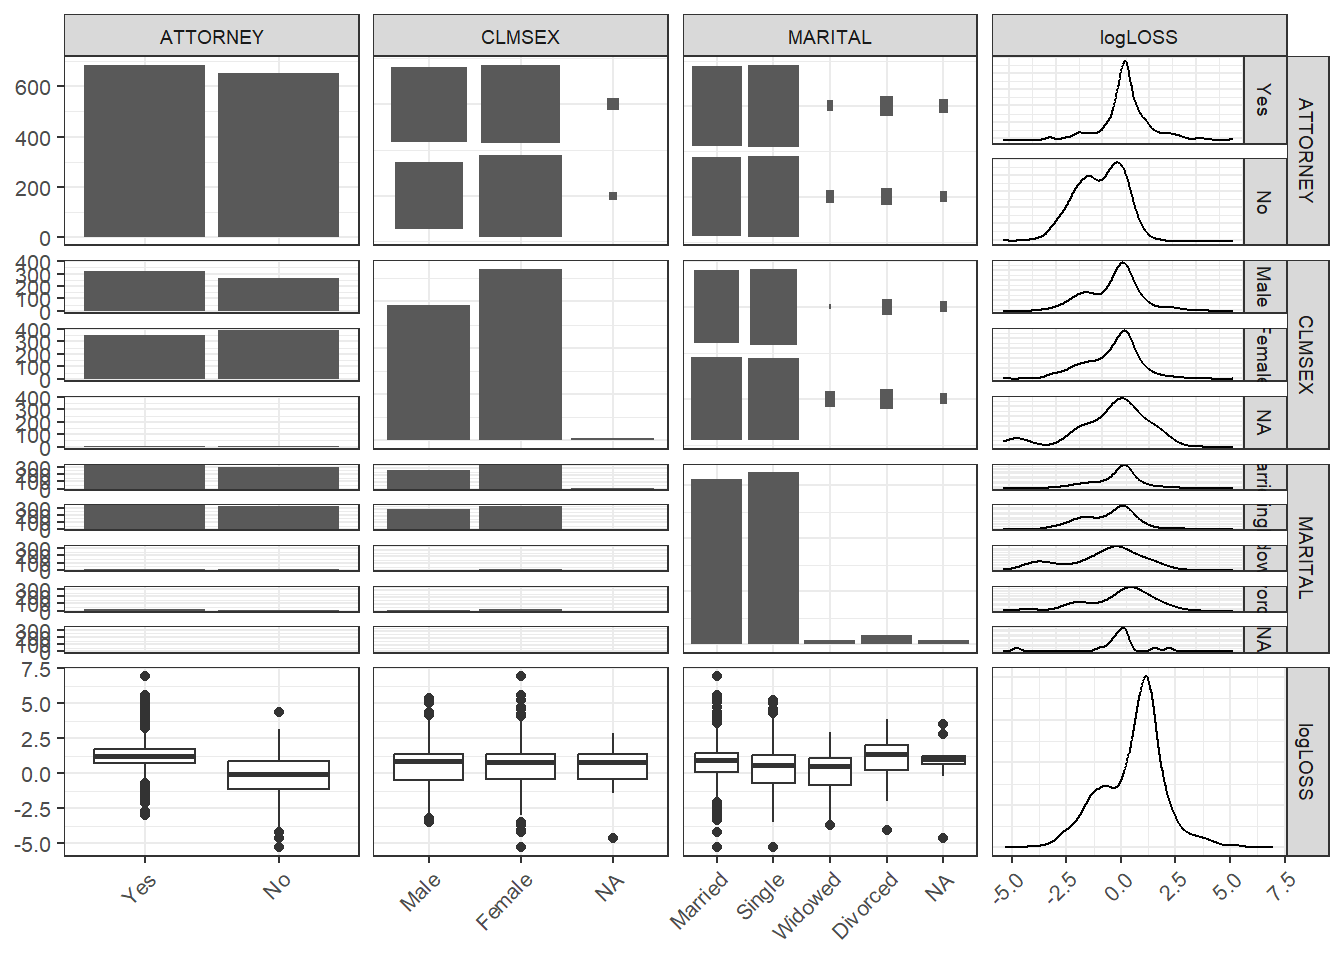
ggpairs (c ("ATTORNEY" , "CLMSEX" , "MARITAL" , "logLOSS" )],upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ + theme_bw () + # 背景を白に theme (axis.text = element_text (size = 8 ), # 軸メモリのサイズ指定 strip.text = element_text (size = 7 ), # パネルタイトルのサイズ指定 + theme (axis.text.x = element_text (angle = 45 ,hjust = 1 # X軸のメモリを斜めにして、hjustで位置調整
最初に比べると見やすくなってきました。現状でも「各項目(または各項目の組み合わせ)の実現値の件数」や、「ATTORNEY(弁護士利用の有無)で損失額の平均・分布が異なっていること」などが、確認できます。
上半分にある「logLOSSとMARITALの組み合わせ」など、カテゴリが多い項目の結果を見やすくすることには限界があるため、詳細を確認したい場合は変数の組み合わせを絞る(例えば、CLMSEXとlogLOSSだけを確認する)、重要でなさそうなカテゴリを統合(または詳細を確認したい値だけに絞る)することが考えられます。
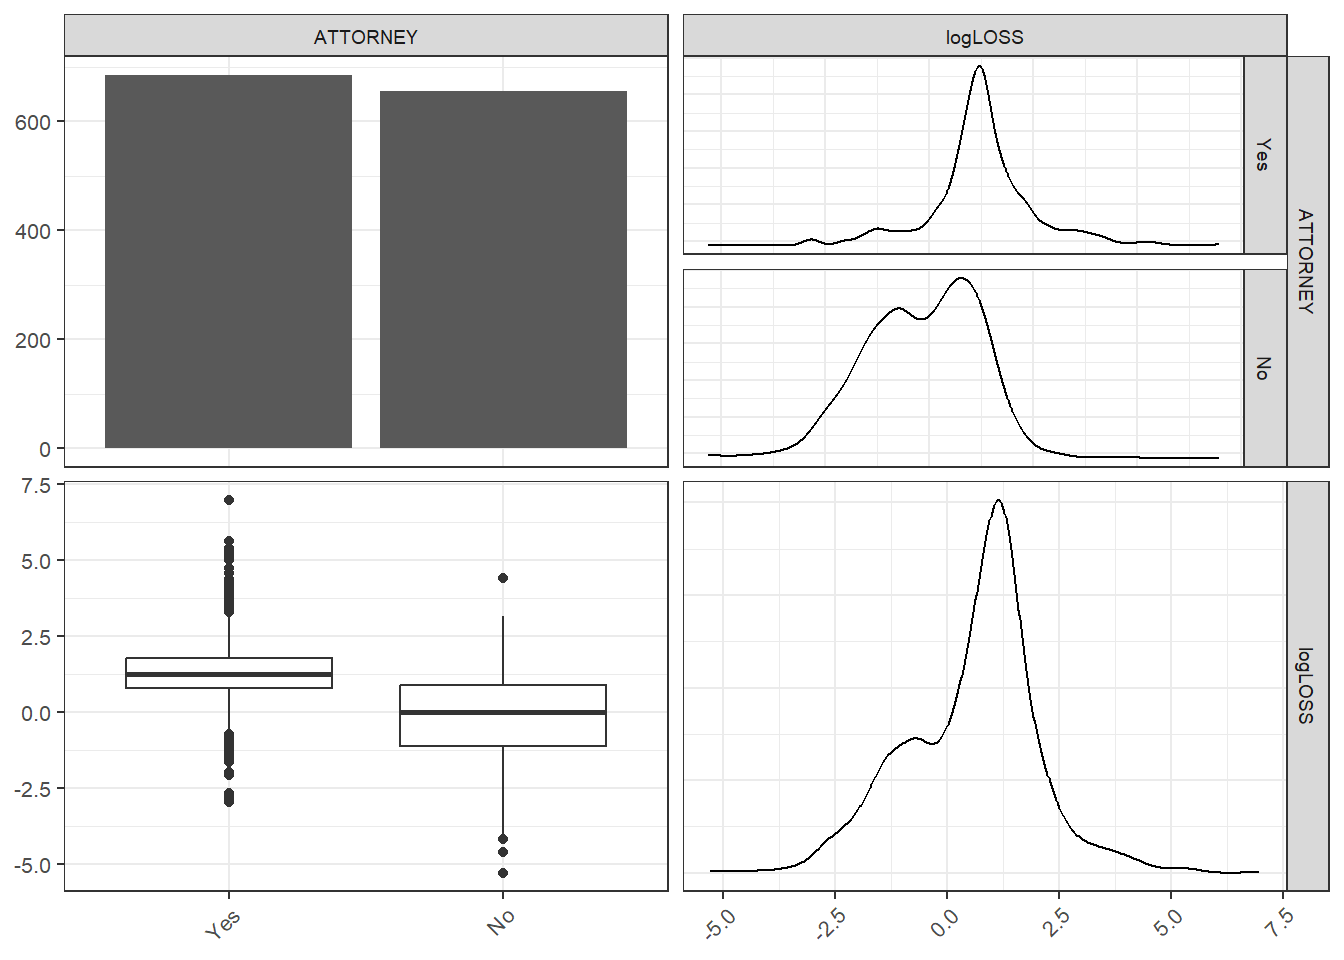
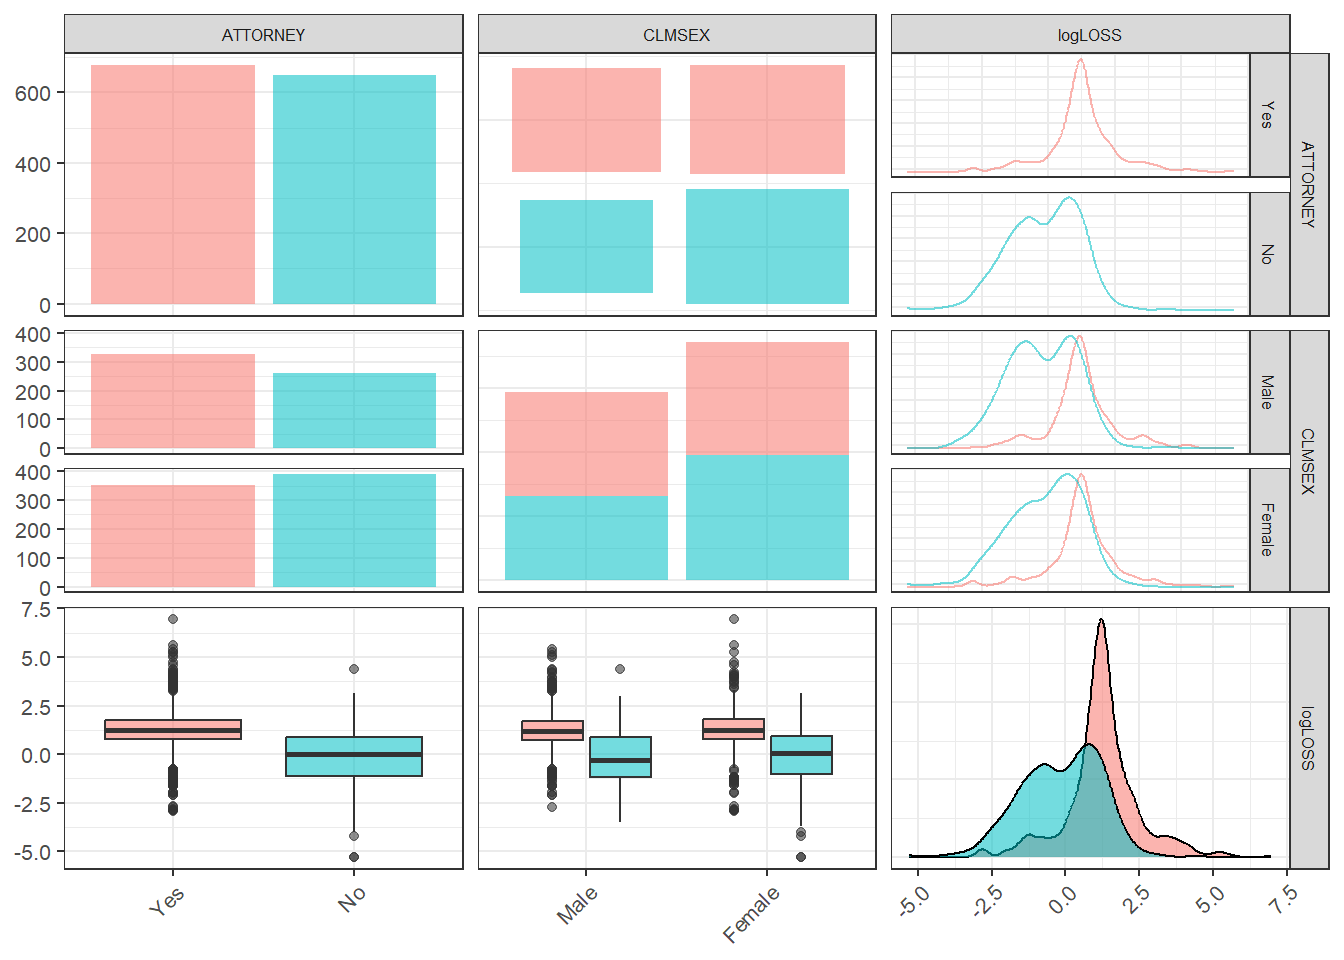
最後に、損失への影響が大きそうなATTORNEYとlogLOSSだけでggpairs関数を実行した場合の結果や、ATTORNEYの値別に色分けをして、CLMSEXとlogLOSSの関係を確認してみます。
# ATTORNEYとlogLOSSの関係を確認 ggpairs (c ("ATTORNEY" , "logLOSS" )],upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ + theme_bw () + # 背景を白に theme (axis.text = element_text (size = 8 ), # 軸メモリのサイズ指定 strip.text = element_text (size = 7 ), # パネルタイトルのサイズ指定 + theme (axis.text.x = element_text (angle = 45 ,hjust = 1 # X軸のメモリを斜めにして、hjustで位置調整 # NAを除いたうえで、ATTORNEYの値で色分けを実施 <- df %>% drop_na (ATTORNEY, CLMSEX, logLOSS)ggpairs (c ("ATTORNEY" ,"CLMSEX" , "logLOSS" )],aes (color = ATTORNEY, alpha = 0.5 ), # ATTORENEYの値で色分け upper = list (discrete = wrap ("count" ), # countは件数 combo = wrap ("facetdensity" ) # facetdensityはカテゴリごとの分布 lower = list (discrete = wrap ("facetbar" ), # facetbarはカテゴリごとの棒グラフ combo = wrap ("box_no_facet" ) # box_no_facetは箱ひげ図 diag = list ( continuous = wrap ("densityDiag" ), # densityDiagは密度曲線 discrete = wrap ("barDiag" ) # barDiagは棒グラフ + theme_bw () + # 背景を白に theme (axis.text = element_text (size = 8 ), # 軸メモリのサイズ指定 strip.text = element_text (size = 6 ), # パネルタイトルのサイズ指定 + theme (axis.text.x = element_text (angle = 45 ,hjust = 1 # X軸のメモリを斜めにして、hjustで位置調整