パッケージの概要
tidyrは、解析や可視化をしやすい形にデータを変換するために、データを整える関数を提供するパッケージです。また、このパッケージは、Rでモダンな分析環境を構築するためのパッケージ群である「tidyverse」に含まれています。
library (tidyr)library (tibble)library (dplyr)
Attaching package: 'dplyr'
The following objects are masked from 'package:stats':

    filter, lag
The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
ワイド形式・ロング形式
tidyrでは、データをワイド形式からロング形式に変換することができます。また、ロング形式からワイド形式に変換することも可能です。
まずは、ワイド形式のデータの例を確認します。WorldPhonesは、世界各地域の電話回線数の推移データで、各行が年、列が地域となっています。
     N.Amer Europe Asia S.Amer Oceania Africa Mid.Amer
1951  45939  21574 2876   1815    1646     89      555
1956  60423  29990 4708   2568    2366   1411      733
1957  64721  32510 5230   2695    2526   1546      773
1958  68484  35218 6662   2845    2691   1663      836
1959  71799  37598 6856   3000    2868   1769      911
1960  76036  40341 8220   3145    3054   1905     1008
1961  79831  43173 9053   3338    3224   2005     1076
WorldPhonesをロング形式に変換してみます。WorldPhonesはmatrixのため、まずはtibbleに変換し、行名(年)をYear列として追加します。また、最終的にWorldPhonesをグラフで可視化するため、あらかじめ1951年のデータを削除しておきます。
<- WorldPhones %>% as_tibble (rownames = "Year" ) %>% filter (Year != "1951" )
pivot_longer関数を利用して、ワイド形式のデータをロング形式に変換します。colsにYear以外の列を指定し、Year以外の列を縦にまとめます。 names_toには、ロング形式に変換して、元の列名をまとめて入れる列の名称を記載します。values_toには、元の値をまとめて入れる列の名称を記載します。
<- tb %>% pivot_longer (cols = - Year, names_to = "Region" , values_to = "Phones" )
# A tibble: 42 × 3
   Year  Region   Phones
   <chr> <chr>     <dbl>
 1 1956  N.Amer    60423
 2 1956  Europe    29990
 3 1956  Asia       4708
 4 1956  S.Amer     2568
 5 1956  Oceania    2366
 6 1956  Africa     1411
 7 1956  Mid.Amer    733
 8 1957  N.Amer    64721
 9 1957  Europe    32510
10 1957  Asia       5230
# ℹ 32 more rows
可視化
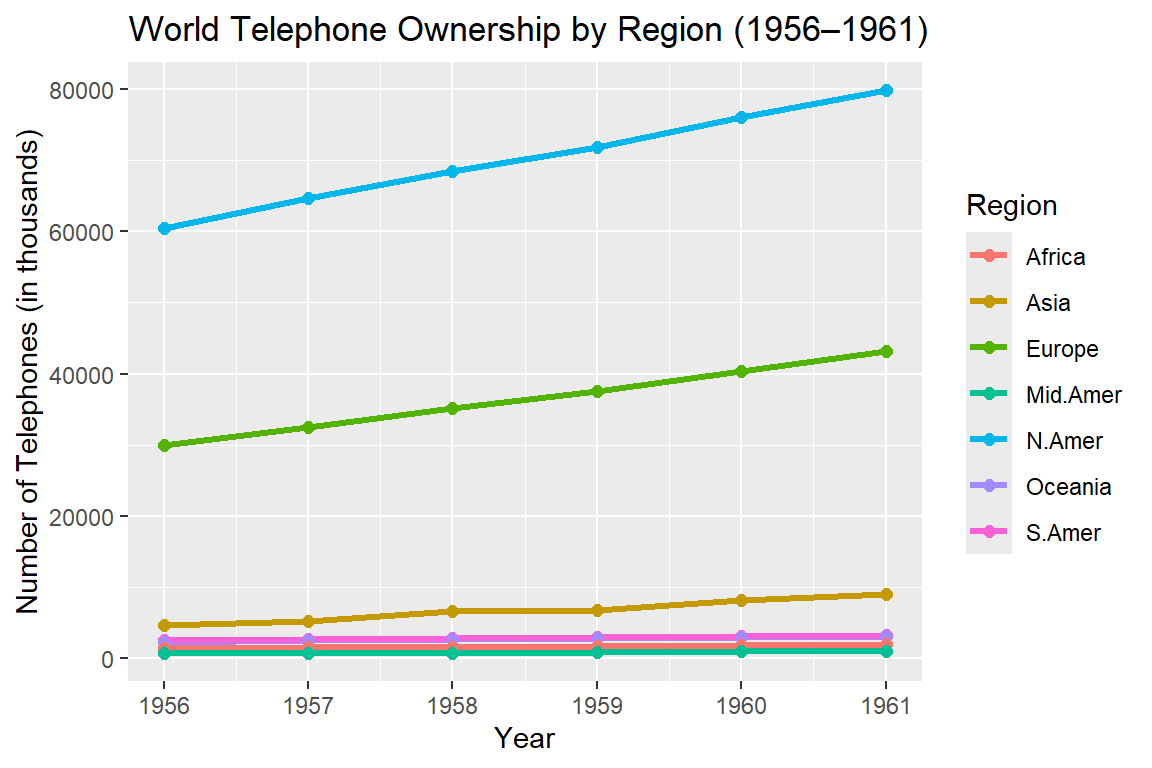
ggplot2パッケージのggplot関数を利用して、tb_longerを可視化してみます。
ggplot (tb_longer,aes (x = as.numeric (Year), y = Phones, color = Region)) + geom_line (linewidth = 1.2 ) + geom_point (size = 2 ) + labs (title = "World Telephone Ownership by Region (1956–1961)" ,x = "Year" ,y = "Number of Telephones (in thousands)" ,color = "Region"
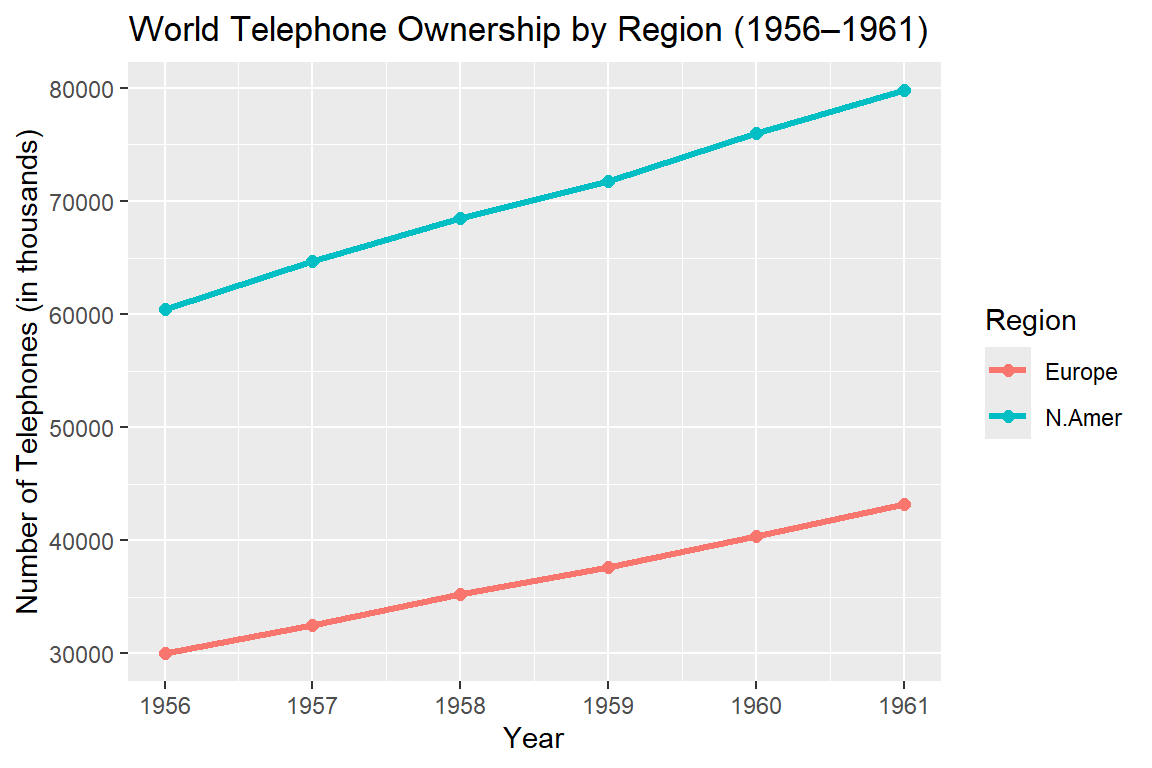
ワイド形式のまま、同じように可視化してみます。ワイド形式でも可視化は可能ですが、geom_lineなどの指定を列ごとに実施する必要があるため、冗長になってしまいます。
<- tb %>% select (Year,N.Amer,Europe)ggplot (tb_selected,aes (x = as.numeric (Year))) + geom_line (aes (y = N.Amer, color = "N.Amer" ), linewidth = 1.2 ) + geom_line (aes (y = Europe, color = "Europe" ), linewidth = 1.2 ) + geom_point (aes (y = N.Amer, color = "N.Amer" ), size = 2 ) + geom_point (aes (y = Europe, color = "Europe" ), size = 2 ) + labs (title = "World Telephone Ownership by Region (1956–1961)" ,x = "Year" ,y = "Number of Telephones (in thousands)" ,color = "Region"
データの整形
tidyrは、データの整形などに利用する関数が揃っており、特定の区切り文字で列を分割(結合)したり、欠損値の処理などが可能です。
# サンプルデータ作成 <- tibble (ID = 1 : 6 ,Name = c ("佐藤" , "鈴木" , "高橋" , "田中" , "伊藤" , "渡辺" ),Date = c ("2025-01-10" , "2025-02-15" , "2025-02-28" , "2025-03-20" , "2025-04-25" , "2025-05-30" ),Score = c (85 , 90 , NA , 75 , 88 , NA ),
# A tibble: 6 × 4
     ID Name  Date       Score
  <int> <chr> <chr>      <dbl>
1     1 佐藤  2025-01-10    85
2     2 鈴木  2025-02-15    90
3     3 高橋  2025-02-28    NA
4     4 田中  2025-03-20    75
5     5 伊藤  2025-04-25    88
6     6 渡辺  2025-05-30    NA
# 特定の区切り文字で分割 # removeは指定しない場合はTRUEとなり、結合前のデータは削除されますが、FALSEにすると残ります <- df %>% separate (col = Date, into = c ("Year" ,"Month" ,"Day" ), sep = "-" , remove = TRUE )
# A tibble: 6 × 6
     ID Name  Year  Month Day   Score
  <int> <chr> <chr> <chr> <chr> <dbl>
1     1 佐藤  2025  01    10       85
2     2 鈴木  2025  02    15       90
3     3 高橋  2025  02    28       NA
4     4 田中  2025  03    20       75
5     5 伊藤  2025  04    25       88
6     6 渡辺  2025  05    30       NA
# 複数の列を1つに結合 # removeは指定しない場合はTRUEとなり、結合前のデータは削除されますが、FALSEにすると残ります <- df_separate %>% unite ("Date_unite" , Year, Month, Day, sep = "-" , remove = FALSE )
# A tibble: 6 × 7
     ID Name  Date_unite Year  Month Day   Score
  <int> <chr> <chr>      <chr> <chr> <chr> <dbl>
1     1 佐藤  2025-01-10 2025  01    10       85
2     2 鈴木  2025-02-15 2025  02    15       90
3     3 高橋  2025-02-28 2025  02    28       NA
4     4 田中  2025-03-20 2025  03    20       75
5     5 伊藤  2025-04-25 2025  04    25       88
6     6 渡辺  2025-05-30 2025  05    30       NA
# A tibble: 6 × 4
     ID Name  Date       Score
  <int> <chr> <chr>      <dbl>
1     1 佐藤  2025-01-10    85
2     2 鈴木  2025-02-15    90
3     3 高橋  2025-02-28    NA
4     4 田中  2025-03-20    75
5     5 伊藤  2025-04-25    88
6     6 渡辺  2025-05-30    NA
# A tibble: 4 × 4
     ID Name  Date       Score
  <int> <chr> <chr>      <dbl>
1     1 佐藤  2025-01-10    85
2     2 鈴木  2025-02-15    90
3     4 田中  2025-03-20    75
4     5 伊藤  2025-04-25    88
# 欠損のある値を指定した値に置換 replace_na (df, list (Score= 0 ))
# A tibble: 6 × 4
     ID Name  Date       Score
  <int> <chr> <chr>      <dbl>
1     1 佐藤  2025-01-10    85
2     2 鈴木  2025-02-15    90
3     3 高橋  2025-02-28     0
4     4 田中  2025-03-20    75
5     5 伊藤  2025-04-25    88
6     6 渡辺  2025-05-30     0