パッケージの概要
ISLR2パッケージは、『An Introduction to Statistical Learning 』という書籍で学習するためのデータなどが提供されているパッケージです。また、学習用にデータが整備されているため、自身でRを学習する際にも利用できます。
なお、ISLR2パッケージが対応しているのは、上記の書籍の第2版であり、ISLRパッケージは初版と対応しています。
library (ISLR2) library (ggplot2)library (GGally)library (tibble)library (knitr)library (dplyr) # filterなどがマスクされる
Attaching package: 'dplyr'
The following objects are masked from 'package:stats':

    filter, lag
The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
データ例
data(package = “ISLR2”)と実行すれば、本パッケージで提供されているデータ名の一覧を確認できます。
複数のデータが提供されていますが、自動車の燃費や、シリンダー数などが格納されているAutoを使ってみましょう。まずは、str関数、head関数、summary関数を実行して、データの概要を確認します。
Autoデータセットの各変数説明
mpg
燃費(1ガロンあたりの走行距離)
cylinders
シリンダー数
displacement
エンジン排気量(立方インチ)
horsepower
エンジン出力(馬力)
weight
車両重量(ポンド)
acceleration
0~60mphまで加速する時間(秒)
year
モデル年(西暦の下2桁)
origin
製造地域(1=アメリカ, 2=ヨーロッパ, 3=日本)
name
車名
'data.frame':   392 obs. of  9 variables:
 $ mpg         : num  18 15 18 16 17 15 14 14 14 15 ...
 $ cylinders   : int  8 8 8 8 8 8 8 8 8 8 ...
 $ displacement: num  307 350 318 304 302 429 454 440 455 390 ...
 $ horsepower  : int  130 165 150 150 140 198 220 215 225 190 ...
 $ weight      : int  3504 3693 3436 3433 3449 4341 4354 4312 4425 3850 ...
 $ acceleration: num  12 11.5 11 12 10.5 10 9 8.5 10 8.5 ...
 $ year        : int  70 70 70 70 70 70 70 70 70 70 ...
 $ origin      : int  1 1 1 1 1 1 1 1 1 1 ...
 $ name        : Factor w/ 304 levels "amc ambassador brougham",..: 49 36 231 14 161 141 54 223 241 2 ...
 - attr(*, "na.action")= 'omit' Named int [1:5] 33 127 331 337 355
  ..- attr(*, "names")= chr [1:5] "33" "127" "331" "337" ...
  mpg cylinders displacement horsepower weight acceleration year origin
1  18         8          307        130   3504         12.0   70      1
2  15         8          350        165   3693         11.5   70      1
3  18         8          318        150   3436         11.0   70      1
4  16         8          304        150   3433         12.0   70      1
5  17         8          302        140   3449         10.5   70      1
6  15         8          429        198   4341         10.0   70      1
                       name
1 chevrolet chevelle malibu
2         buick skylark 320
3        plymouth satellite
4             amc rebel sst
5               ford torino
6          ford galaxie 500
      mpg          cylinders      displacement     horsepower        weight
 Min.   : 9.00   Min.   :3.000   Min.   : 68.0   Min.   : 46.0   Min.   :1613
 1st Qu.:17.00   1st Qu.:4.000   1st Qu.:105.0   1st Qu.: 75.0   1st Qu.:2225
 Median :22.75   Median :4.000   Median :151.0   Median : 93.5   Median :2804
 Mean   :23.45   Mean   :5.472   Mean   :194.4   Mean   :104.5   Mean   :2978
 3rd Qu.:29.00   3rd Qu.:8.000   3rd Qu.:275.8   3rd Qu.:126.0   3rd Qu.:3615
 Max.   :46.60   Max.   :8.000   Max.   :455.0   Max.   :230.0   Max.   :5140

  acceleration        year           origin                      name
 Min.   : 8.00   Min.   :70.00   Min.   :1.000   amc matador       :  5
 1st Qu.:13.78   1st Qu.:73.00   1st Qu.:1.000   ford pinto        :  5
 Median :15.50   Median :76.00   Median :1.000   toyota corolla    :  5
 Mean   :15.54   Mean   :75.98   Mean   :1.577   amc gremlin       :  4
 3rd Qu.:17.02   3rd Qu.:79.00   3rd Qu.:2.000   amc hornet        :  4
 Max.   :24.80   Max.   :82.00   Max.   :3.000   chevrolet chevette:  4
                                                 (Other)           :365
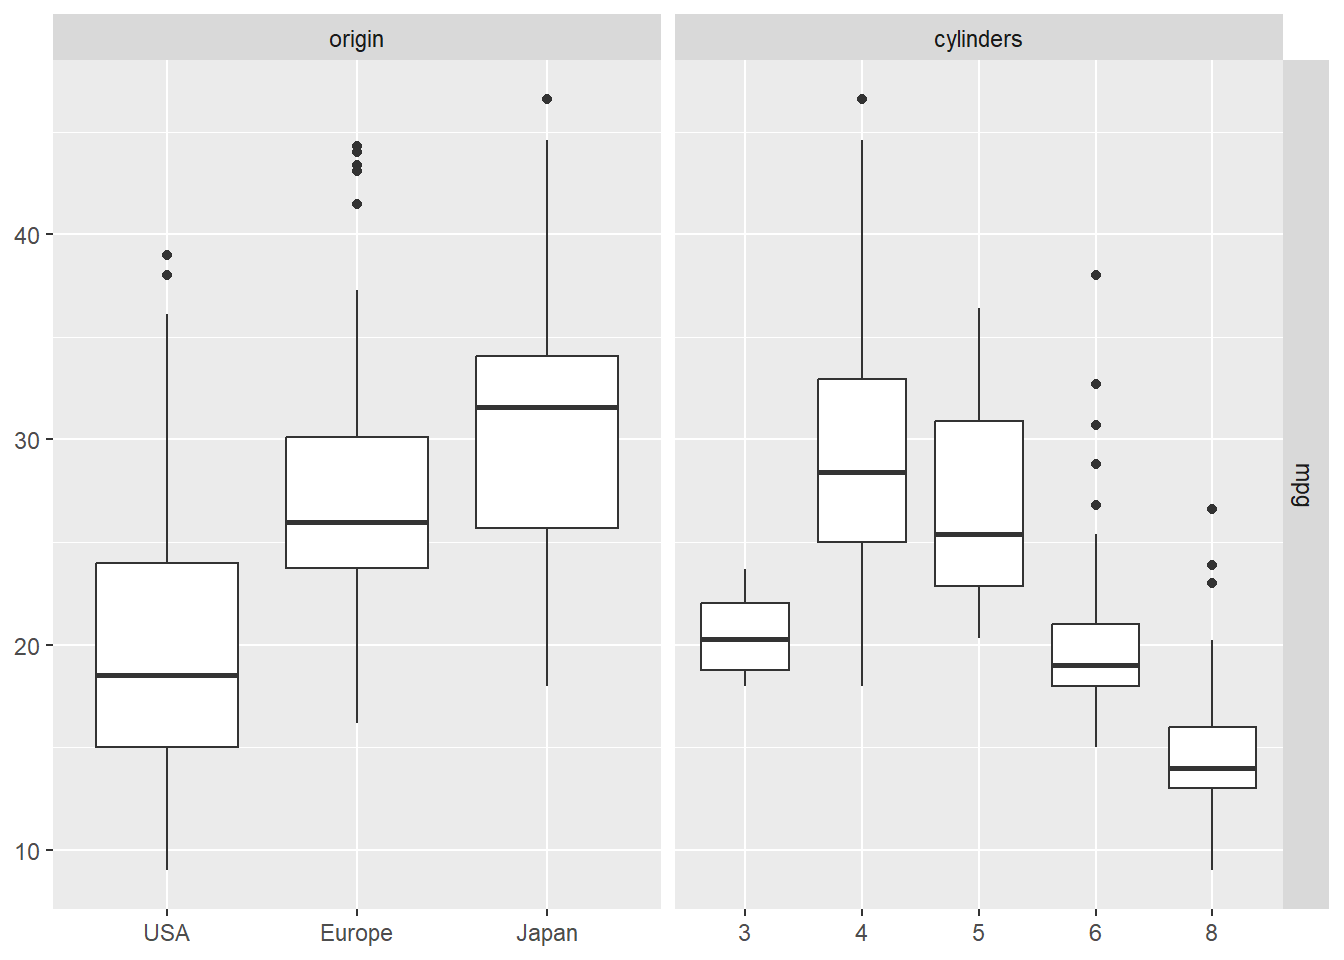
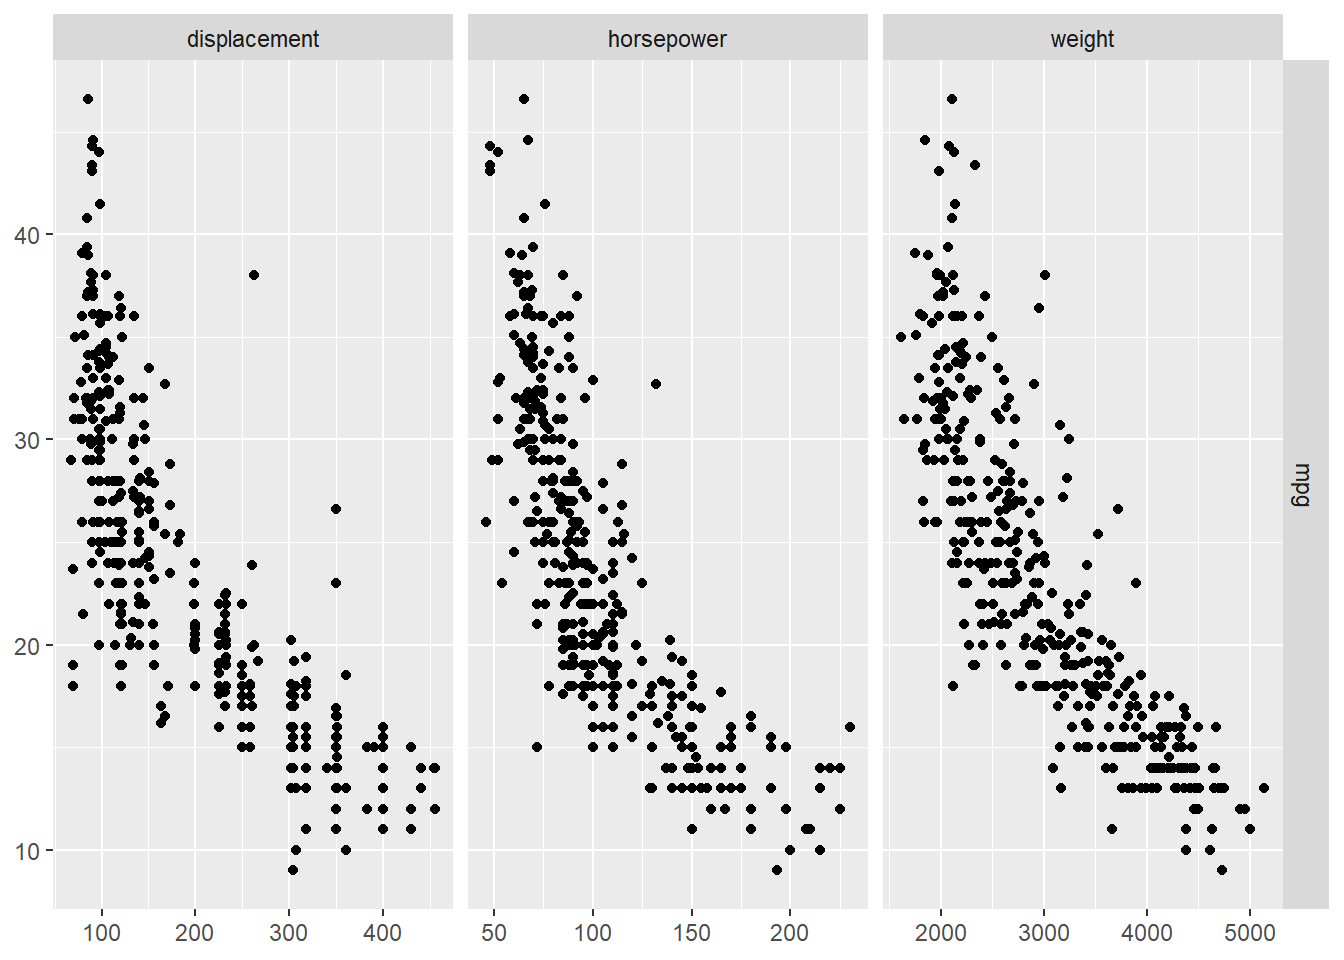
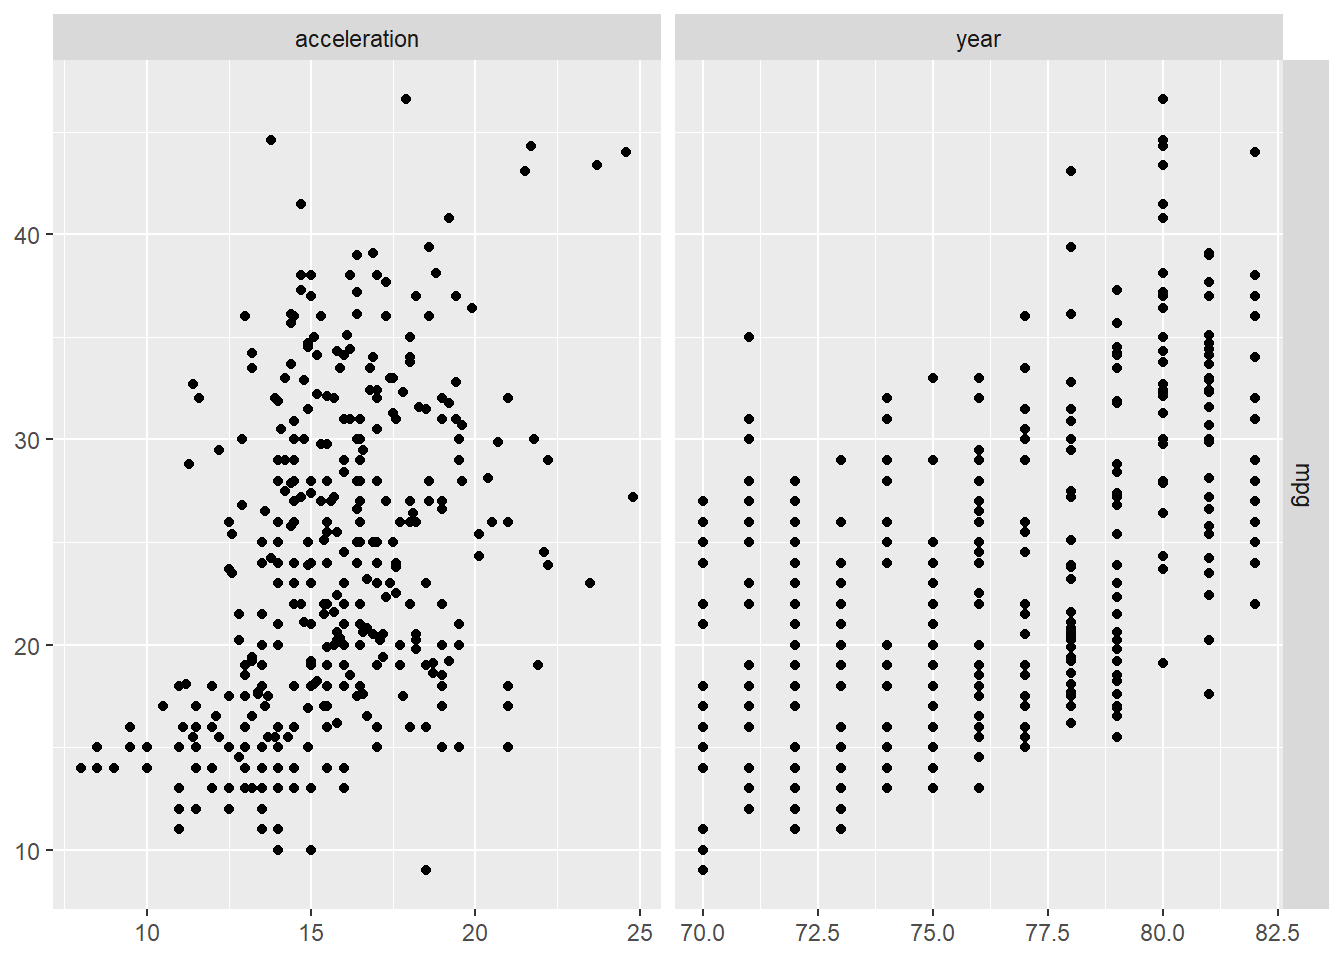
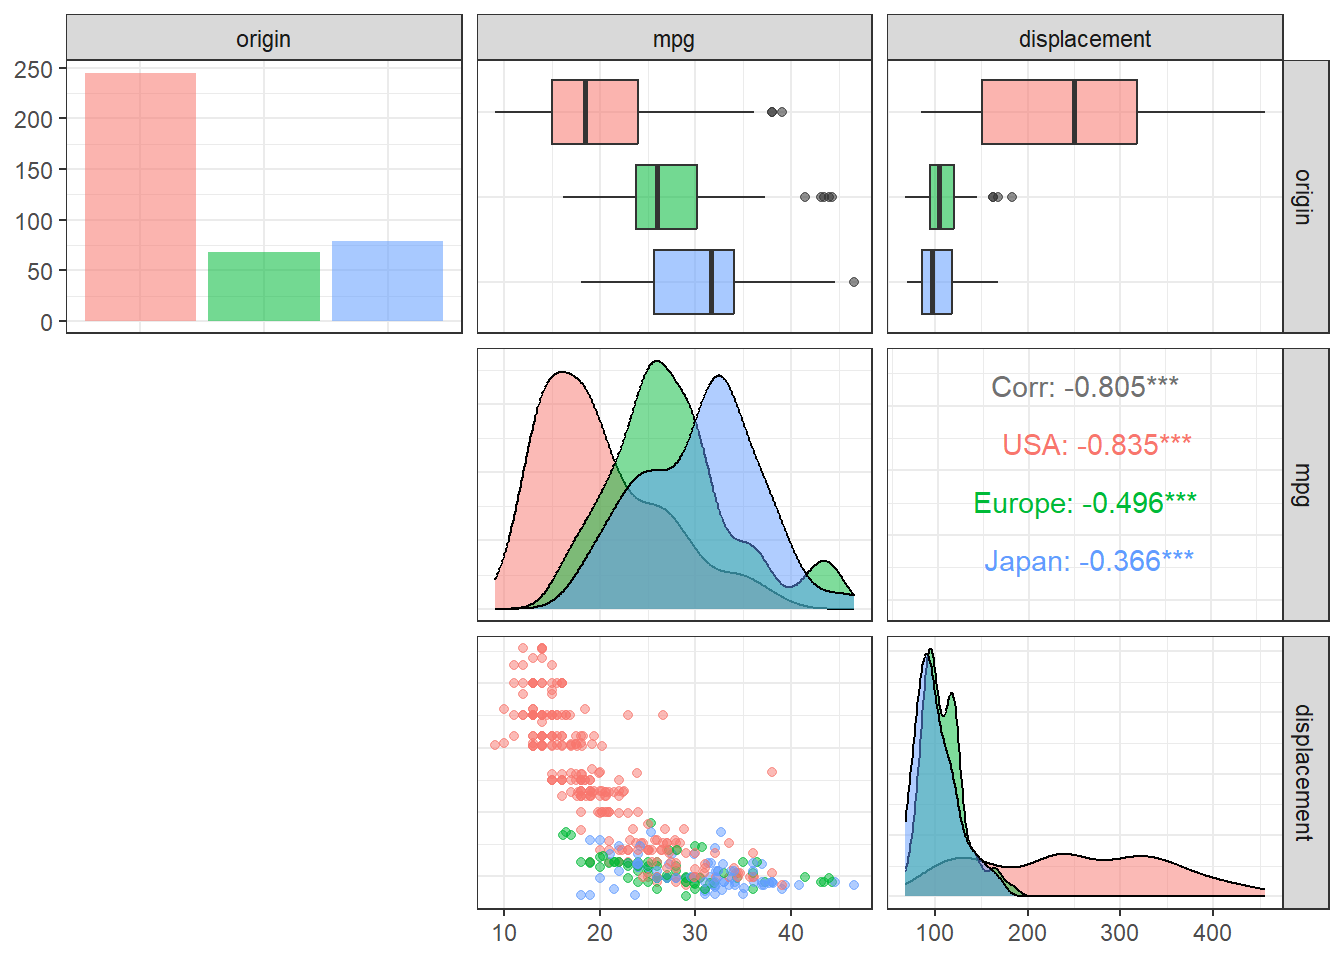
続いて、GGallyパッケージのggduo関数や、ggpairs関数を利用して、mpgと各項目の関係を確認してみます。 ただし、nameはstr関数などで確認した結果、パターン数が多く、分析に利用することが難しいことがわかりますので除外します。
ggduo関数では、mpg(燃費)と各項目の関係を可視化しています。また、ggpairs関数では、mpg(燃費)とdisplacement(排気量)の関係をorigin(製造地域)ごとに確認しています。(箱ひげ図を表示するため、originとcylindersをカテゴリ変数に変換しています)
<- Auto |> mutate (origin = factor (labels = c ("USA" , "Europe" , "Japan" )cylinders = factor (cylinders)ggduo (columnsX = c ("origin" ,"cylinders" ),columnsY = c ("mpg" ),types = list (combo = "box_no_facet" # comboはカテゴリ変数と数値変数の設定。箱ひげ図を指定 ggduo (columnsX = c ("displacement" ,"horsepower" , "weight" ),columnsY = "mpg" ,types = list (continuous = "points" # continuousは数値変数同士の設定。散布図を指定 ggduo (columnsX = c ("acceleration" , "year" ),columnsY = "mpg" ,types = list (continuous = "points"
ggpairs (c ("origin" , "mpg" , "displacement" )],aes (color = origin, alpha= 0.5 ), upper = list (continuous = wrap ("cor" ), # 数値変数同士の場合、相関係数を表示 combo = wrap ("box_no_facet" ) # カテゴリ変数と数値変数の場合、箱ひげ図を表示 lower = list (continuous = wrap ( "points" ,size = 1.5 ,alpha = 0.5 # 数値変数同士の場合、散布図を表示 combo = wrap ("blank" ) # カテゴリ変数と数値変数の場合、何も表示しない diag = list (continuous = wrap ( "densityDiag" ,alpha = 0.5 # 数値変数同士の場合、密度曲線を表示 discrete = wrap ("barDiag" ) # カテゴリ変数同士の場合、度数分布を表示 + theme_bw () # 背景を白に